Как проверить работу агента до принятия результата
AI Engineering · 27 октября — 2 ноября 2026
Агент может выбрать неподходящий код, повторить неудачное исправление или убедительно объяснить небезопасный патч. В этих двадцати материалах авторы разбирают такие ситуации и предлагают способы проверять контекст, решения и стоимость работы. Результаты и границы экспериментов раскрыты в карточках.
Найдено: 20
Ничего не найдено. Попробуйте другой запрос или сбросьте фильтры.
Исследования
Yuzhe Liu, Haolin Tian, Tonghan Wang · · Препринт
ACCT: как передать уже вычисленный контекст другой модели
agents
При переключении между моделями длинный контекст приходится обрабатывать заново. ACCT предлагает переносить KV-кэш — сохранённые состояния контекста — через обучаемый интерфейс между моделями одного семейства. Работа помогает оценить такую архитектуру маршрутизатора: выигрыш зависит от пары моделей, а если готового кэша ещё нет, нужно учесть и его вычисление.
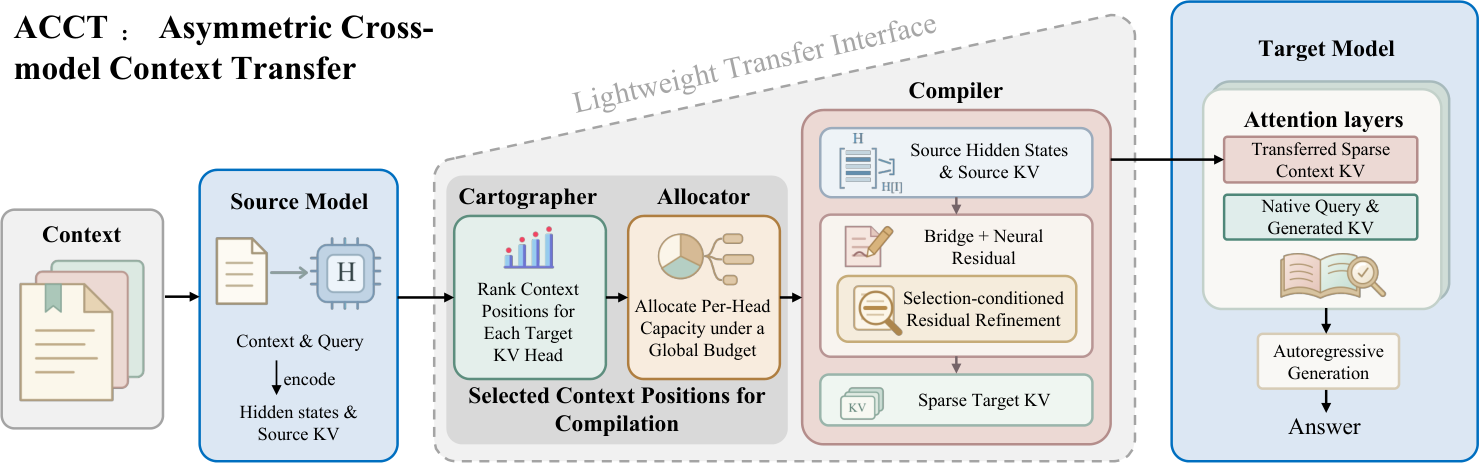
ACCT выбирает часть позиций контекста и преобразует их состояния в KV-кэш другой модели. ИсточникМетод, ограничения и следующий шаг
Как устроено. Авторы замораживают обе модели и обучают интерфейс для каждого направления переноса. Cartographer выбирает позиции контекста под запрос, Allocator распределяет четверть исходных KV-слотов, Compiler преобразует состояния для целевой модели. Контрольный вариант — та же целевая модель, которая сама обрабатывает полный контекст.
Основание. По эксперименту авторов. Оценка качества: 10 000 одинаковых примеров, 11 наборов, шесть направлений Qwen3, Llama и Qwen2.5. Задержка: A800 80GB, BF16/SDPA, batch size 1, восемь контекстов на направление, ~1K–19K токенов; приведены медианы стадий. Target Full — контроль с полным контекстом, а DroidSpeak/C2C не выступают сопоставимыми baselines. В таблице 15 добавлено вычисление исходного кэша; обработка запроса и генерация ответа исключены и там.
Ограничение. Нужны совместимые token-to-ID mappings и отдельное обучение интерфейса. Ускорение 6,5–21,2× измерено только для преобразования готового кэша вместо обработки контекста целевой моделью. Если сначала вычислить исходный кэш, прямые направления на ~19K токенов дают 1,16–3,35×; обработка запроса и генерация ответа всё ещё не учтены. В отдельных задачах качество сильно падает, в дополнении для нескольких задач 14B→4B — ниже 1 %.
Для моей работы. При проектировании маршрутизатора между моделями можно рассматривать контекст как повторно используемое вычисление. Практический вывод редактора — измерять стоимость построения состояний отдельно от задержки полного ответа и не усреднять провалы по задачам.
Следующий шаг. Пока наблюдать за воспроизводимой реализацией; для собственного эксперимента выбрать одну совместимую пару, сравнить полный latency budget и качество на целевых задачах.
Есть ли среди восьми вариантов действие лучше случайного
agents
Дорогой поиск бесполезен, если предложенные действия почти не отличаются по качеству или селектор не умеет выбрать лучшее. Авторы проверили эти предпосылки у Cosmos Policy в симуляторе RoboCasa: сравнили выбор кандидатов, время полного запроса и ошибки среды. Работа даёт схему аудита перед увеличением вычислительного бюджета; в этом эксперименте обученный селектор проиграл случайному.
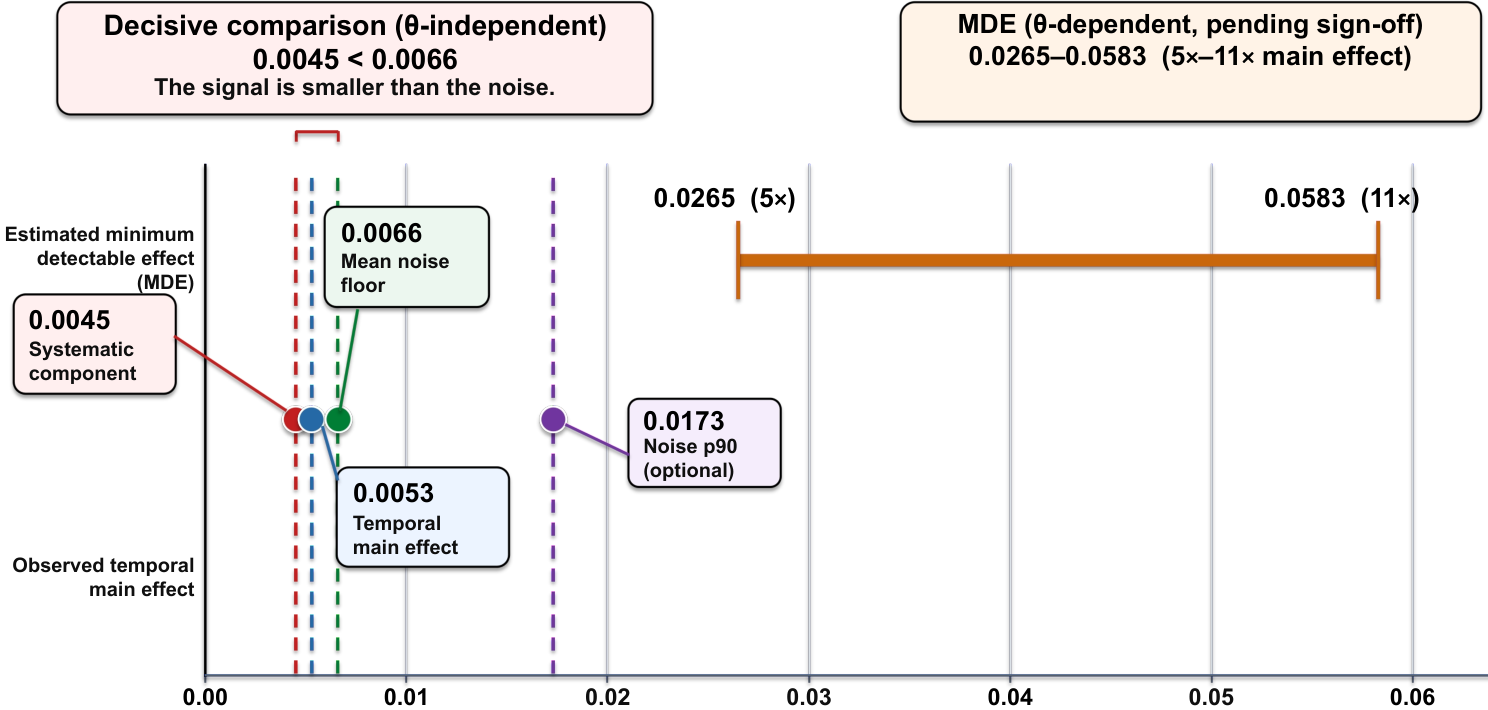
Слева ожидаемый эффект меньше шума измерения; справа — более широкий порог обнаружения, ещё ожидающий утверждения. ИсточникМетод, ограничения и следующий шаг
Как устроено. Авторы возвращают симулятор в одно состояние и сравнивают восемь кандидатов при одинаковом продолжении, с двумя повторами. Oracle выбирает лучший исход задним числом и служит верхней оценкой, недоступной при эксплуатации. Отдельно измеряют полный запрос с затратами pruning — отсечения вычислений — и проверяют повреждения изображения через framebuffer sentinel. Power gate заранее останавливает эксперимент, если точности измерений не хватает для различения нужного эффекта.
Основание. По эксперименту авторов. Selection audit: четыре задачи, три эпизода, 263 состояния, N=8 и R=2. Выбор value даёт −1,66 п. п. к случайному, oracle — +1,40 п. п., episode-bootstrap CI [−0,25; +3,40]. Замер на RTX A6000: bf16, batch 1, пять denoising steps, 30 запросов на условие. Снижение FLOPs одного прохода на 47,9 % даёт ускорение полного запроса 1,152×: 1254,9→1088,9 мс, примерно −13,2 % времени.
Ограничение. Проверен один стек Cosmos Policy–RoboCasa. Доверительный интервал oracle включает ноль, поэтому потолок пользы поиска остаётся неопределённым. При pruning измеряли задержку, но не качество действий. Power gate на 16 состояниях не пройден; калибровка порога ещё не утверждена, вывод об adaptive allocation не получен. До 65 % повреждений изображения относятся к нестандартному планированию с большим объёмом вычислений. В supplement есть ошибки: ускорение 1,152× названо снижением времени на 15,2 %, а для official-corruption расходятся знаменатели 8/200 и 8/1200; частоту 0,67 % не используем.
Для моей работы. Мой вывод: перед дорогим поиском backend-агента нужно проверить, есть ли полезные различия между кандидатами. Полное время запроса и корректность среды стоит измерять отдельно. Это поможет отличить слабый селектор от отсутствия полезного сигнала или ошибки инфраструктуры.
Следующий шаг. В своём best-of-N сравнить случайный выбор, рабочий селектор и oracle на одном пуле кандидатов. Заранее выбрать единицу bootstrap и бюджет, затем решить, нужен ли масштабный запуск.
ArchOR: искать skill по структуре задачи и проверять замену baseline
agents
Похожие формулировки задачи могут требовать разных навыков оптимизационного моделирования. ArchOR сначала ищет skill по структуре задачи, затем решает, стоит ли заменить им выбор базового селектора. Именно этот второй шаг оказался важен: обязательный переход на новый маршрут ухудшал конечный результат, а выборочный override помогал сохранить правильные решения.
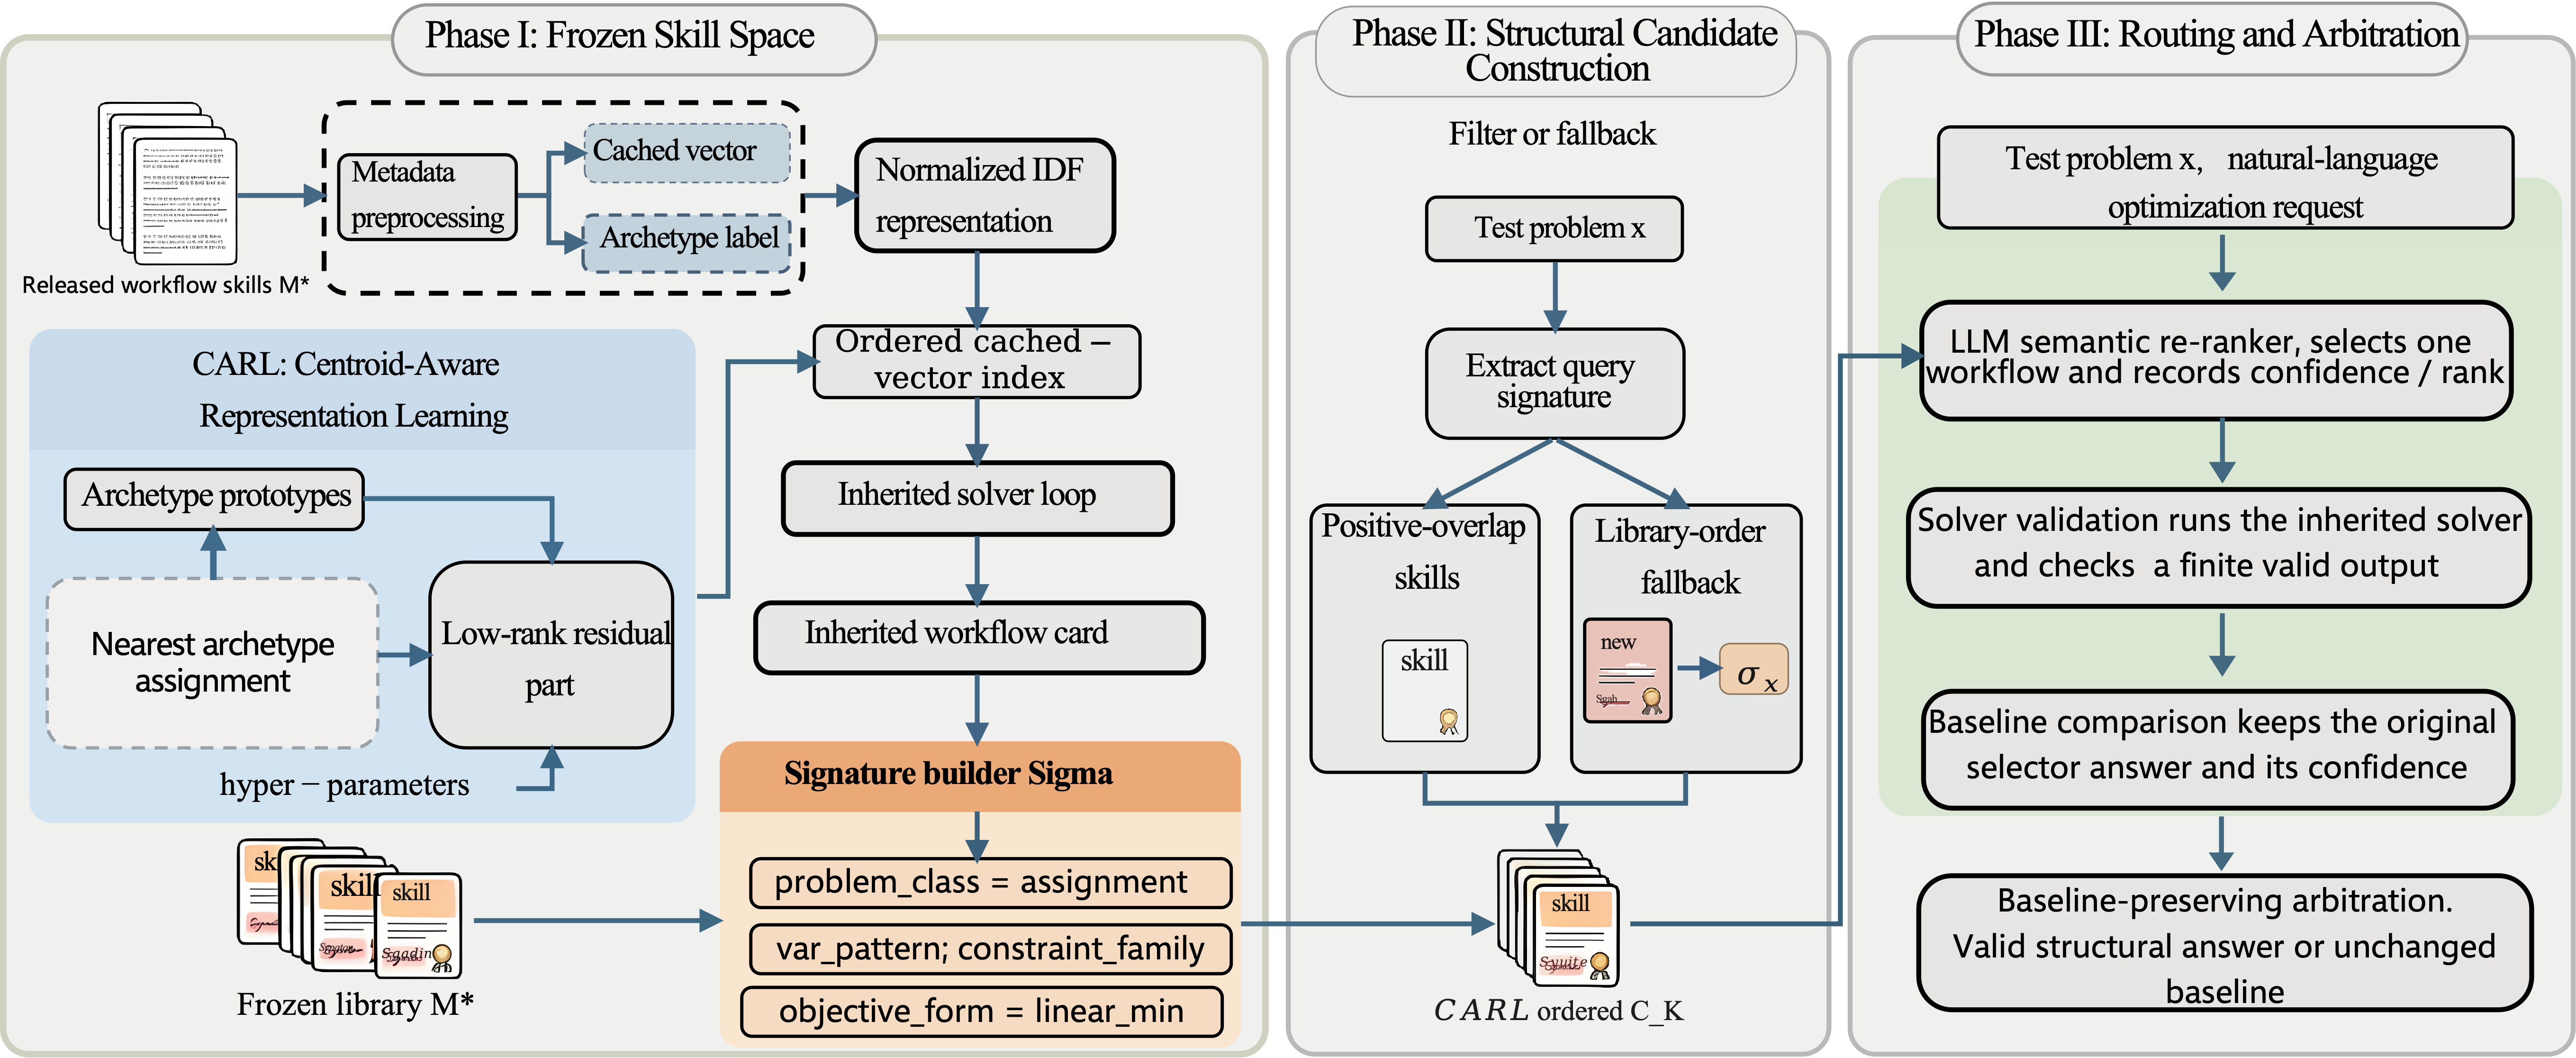
ArchOR ищет структурно подходящий skill, проверяет его и решает, заменить ли маршрут baseline. ИсточникМетод, ограничения и следующий шаг
Как устроено. Библиотека OptSkills из 46 навыков и модель DeepSeek-V4.1-Flash остаются неизменными. CARL сдвигает векторы к структурным прототипам, а S3R оставляет для semantic reranking восемь подходящих кандидатов. Затем арбитраж сопоставляет confidence селекторов, ранг навыка и результат solver. Он принимает новый маршрут либо сохраняет baseline.
Основание. По эксперименту авторов. 1 100 запросов из пяти наборов задач, temperature 0, seed 42, до 12 шагов и solver timeout 120 секунд. Micro accuracy растёт с 63,36 до 65,00 %: 23 исправленных ответа и 5 регрессий, итог +18, точный тест Макнемара p=0,0009. При обязательном выборе CARL+S3R результат — 61,45 %, ниже baseline. Рост retrieval Hit@1 с 0,607 до 0,804 сам по себе не означает улучшения конечного решения.
Ограничение. Одна модель, по одному запуску на запрос; условия и размер выборки указаны в «Основании». Пороги арбитража не проверены на независимой выборке. Процедура исполняет обе ветви, поэтому сокращение списка с 46 до 8 не доказывает экономию времени или денег. Успешное выполнение solver и совпадение целевой функции не гарантируют верную семантику модели: в случае F1 арбитраж заменил правильный baseline ошибочным решением. Внешние строки таблицы не перезапускали.
Для моей работы. Для библиотеки agent skills полезно логировать совместимость структуры, позицию кандидата, решение селектора и причину override. Это отделяет ошибку поиска от неверной границы применимости навыка; перенос на обычные backend-задачи требует собственной проверки.
Следующий шаг. На сохранённых задачах сравнить baseline, обязательный новый retrieval и селективный override. Добавить атрибуты предусловий и собрать независимую выборку для калибровки порогов.
Haofu Yang, Hongyang Yin, Ran Bi et al. · · Препринт
AOD: когда агенту стоит спросить коллегу
agents
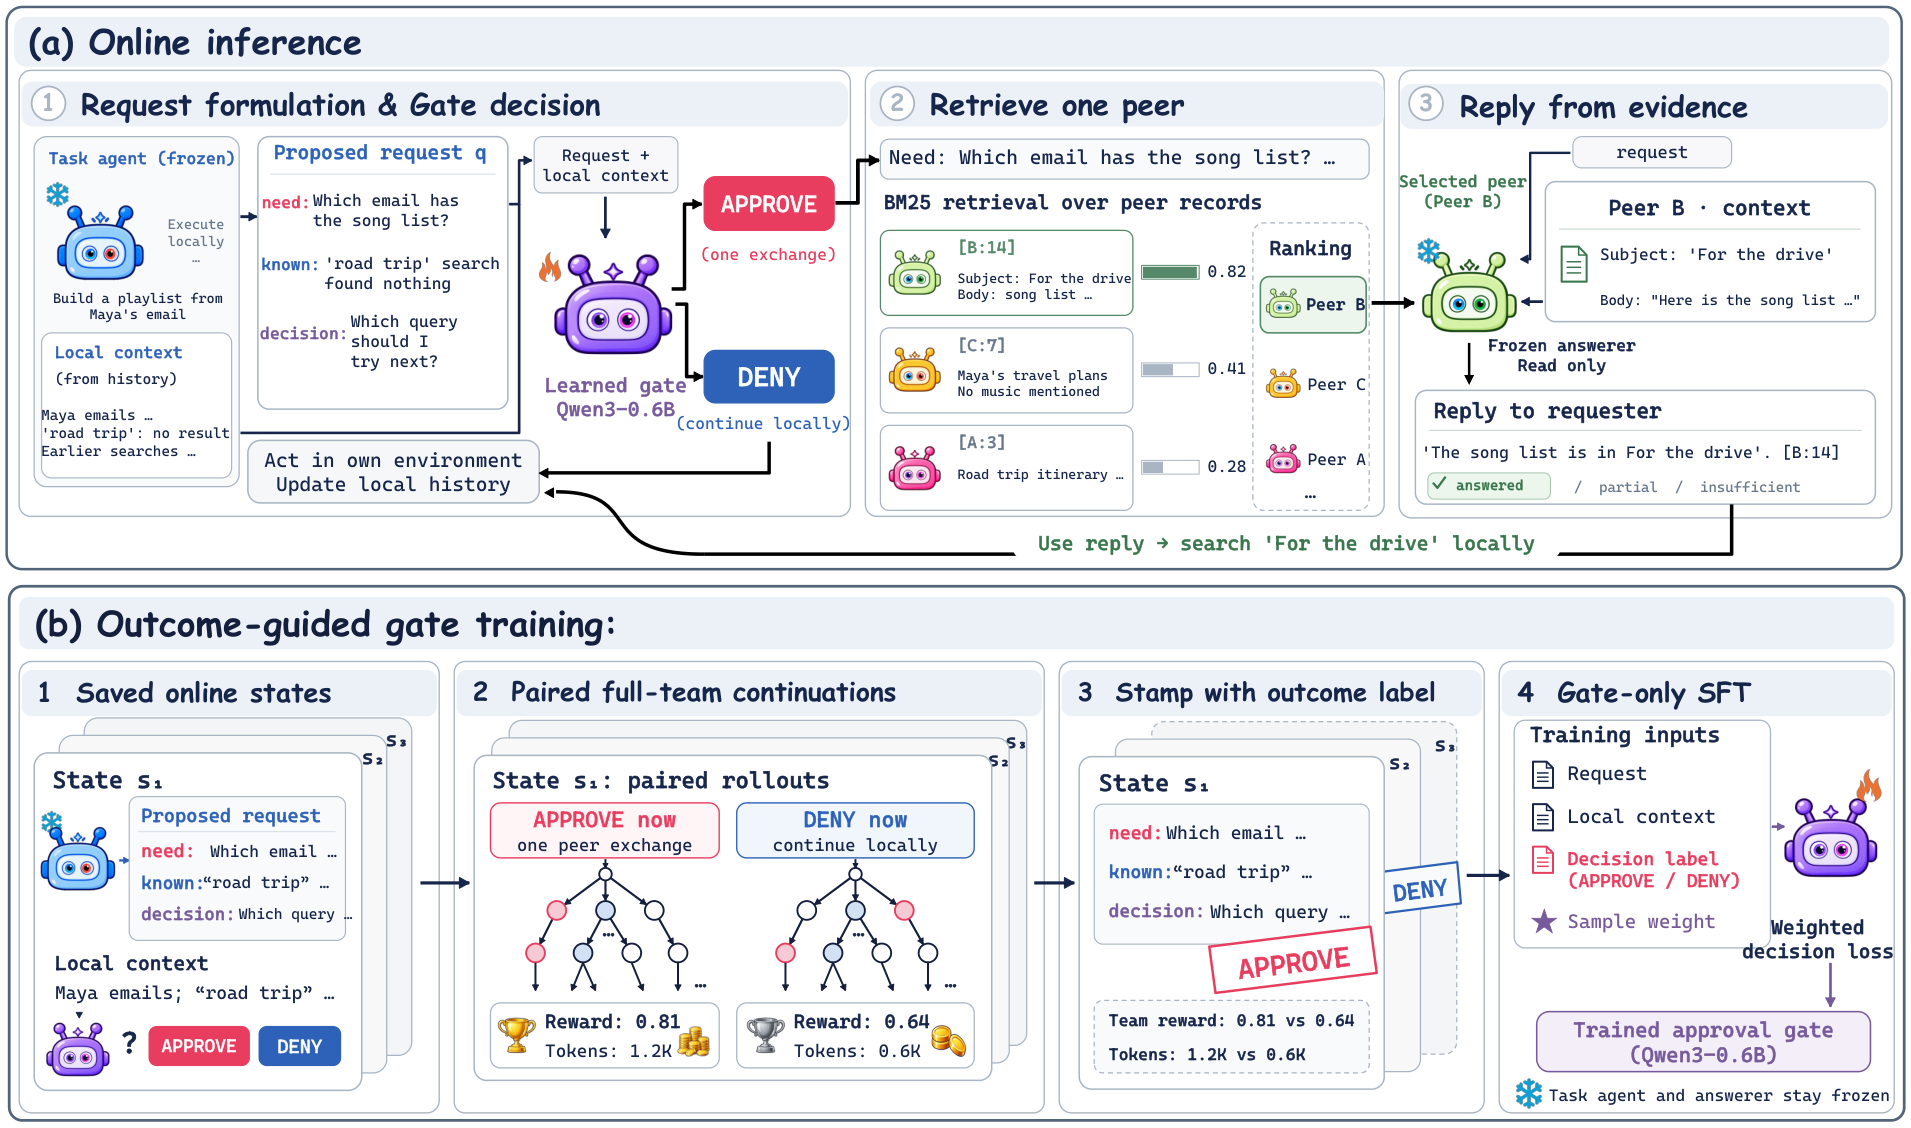
Параллельные агенты могут повторять чужую работу, а постоянный обмен сводками расходует контекст. В AOD агент задаёт коллеге конкретный вопрос, и обученный gate разрешает обращение, если оно помогает команде закончить задачу. На AppWorld и WebShop такой обмен улучшал результат относительно независимых запусков; польза зависела от модели и способа выбора итогового ответа.
Gate разрешает вопрос коллеге; агент получает ответ с цитатами и сам проверяет его перед действием. ИсточникМетод, ограничения и следующий шаг
Как устроено. Три агента решают задачу в отдельных средах. После разрешения gate поиск BM25 выбирает завершённые записи коллеги, а замороженная модель отвечает по ним с цитатами. Gate на Qwen3-0.6B обучают на двух продолжениях одного состояния: с разрешённым запросом и без него. Сначала учитывают командный результат, при равенстве — стоимость. После обучения эти парные продолжения больше не нужны.
Основание. По эксперименту авторов. Таблица 1: Qwen3.5-35B-A3B, три агента, AppWorld TGC 53,89 у Independent и 62,78 у AOD, +8,89 п. п.; 120 задач, среднее трёх seed. Это не общий процент успешности production-агента. На 4B AppWorld AOD уступает LTS по выбранному результату.
Ограничение. Проверены 120 задач AppWorld и 200 WebShop, две Qwen-модели и три seed. AOD уступает LTS на 4B AppWorld при выборе ответа по confidence. Затраты хранения и retrieval не учтены; Agentfugue дополнительно сжимает контекст, поэтому сравнение токенов не выделяет стоимость общения. Внешний supplementary material не входит в сохранённый HTML: детали splits, правил отбора и отказов, критериев стабильности и адаптации baselines здесь не подтверждены.
Для моей работы. Мой вывод: полезная схема интерфейса помощи для backend-команды агентов — вопрос должен называть решение, а ответ сохранять проверяемые свидетельства. Результат исследования не доказывает, что дополнительные агенты окупятся в конкретном production-процессе.
Следующий шаг. Сначала добавить need/known/decision и ссылки на записи в свой протокол помощи; сравнить независимые запуски и запросы по требованию на одинаковом бюджете, учитывая retrieval и выбор финального ответа.
LEAP: предсказывать длину ответа, пока GPU обрабатывает запрос
agents
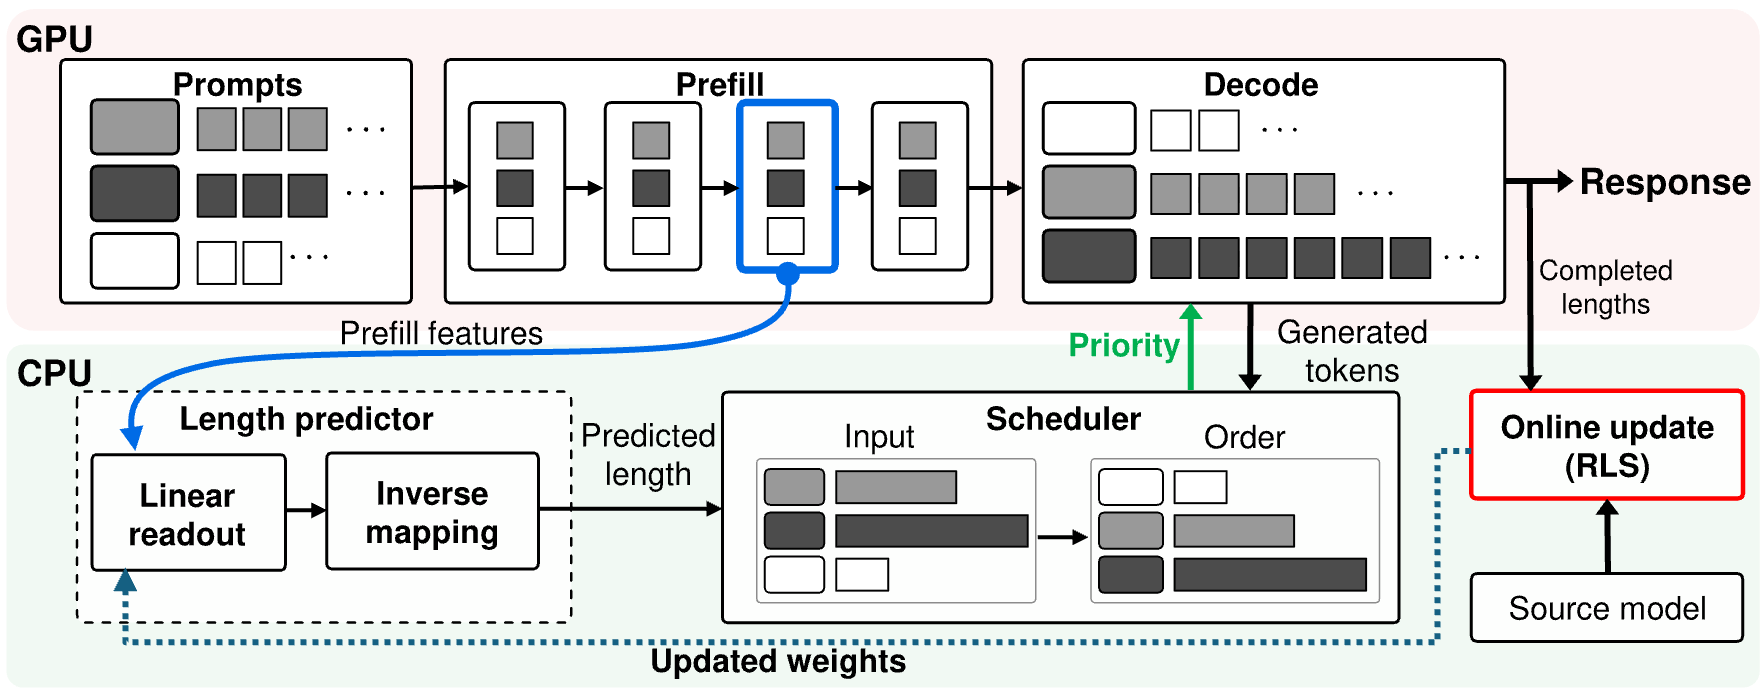
Чтобы планировать очередь генерации, серверу полезно знать, сколько токенов ещё выдаст модель. LEAP получает прогноз из промежуточного состояния модели и считает его на CPU параллельно с работой GPU. Завершённые запросы обновляют прогноз. Работа показывает, почему scheduler нужно оценивать целиком: более точный прогноз может обойтись дороже, чем сэкономленное ожидание.
CPU предсказывает длину ответа, пока GPU обрабатывает запрос; scheduler использует прогноз для очереди. ИсточникМетод, ограничения и следующий шаг
Как устроено. Линейная Ridge-модель предсказывает квадратный корень длины ответа по состоянию последнего токена позднего слоя. CPU-worker асинхронно публикует оценку с ID запроса и версией модели. Scheduler вычитает уже сгенерированные токены и защищает долго ожидающие запросы; без оценки возвращается к FCFS — порядку поступления. Каждые восемь завершений RLS обновляет коэффициенты по фактической длине.
Основание. По эксперименту авторов. Таблица 3: ShareGPT, один A800 80 GB PCIe, восемь логических CPU, vLLM 0.8.5.post1; 500 одинаковых запросов при 2,65 запроса/с. Среднее PTL у LEAP — 63,58 против 75,62 мс/токен у LTR, улучшение 15,9 %. Throughput — 1 141,93 против 1 120,88 токена/с, +1,9 %. PTL делит полную задержку на число выходных токенов и не измеряет интервал между ними.
Ограничение. Основные serving-замеры — одиночные прогоны vLLM в eager-mode на одном GPU и общем хосте, с пределом ответа 2 048 токенов. Длинные запросы могут ждать дольше. В симуляции переноса на другой домен затраты predictor не учтены, а P95 иногда ухудшается. Static/dynamic варианты различаются также целями обучения. Prefix cache, chunked prefill и multi-GPU не проверены; RLS не забывает старые наблюдения и не учитывает decoding policy.
Для моей работы. Мой вывод: для inference backend нужно измерять путь от получения признаков до использования оценки scheduler, включая работу CPU. ID запросов и версии результатов также помогают не применить запоздавший асинхронный прогноз к другой задаче.
Следующий шаг. На копии нагрузки измерить среднее и P95/P99 полного ответа с одинаковыми последовательностями токенов; отдельно учесть CPU, передачу features, защиту ожидания и переходы между доменами.
Yanran Wu, Dian Yu, Chongyang Bai et al. · · Препринт
DecisionRank: ранжировать документы без генерации списка
agents
В RAG повторное ранжирование найденных документов может задерживать весь ответ. DecisionRank оценивает до ста кандидатов по первому токену модели и сортирует оценки, не генерируя список. Чтобы обучить быстрый reranker, авторы передают ему rankings дорогого учителя и обратную связь на текущий выбор. Выигрыш проверен на нескольких наборах; полный путь RAG нужно измерять отдельно.
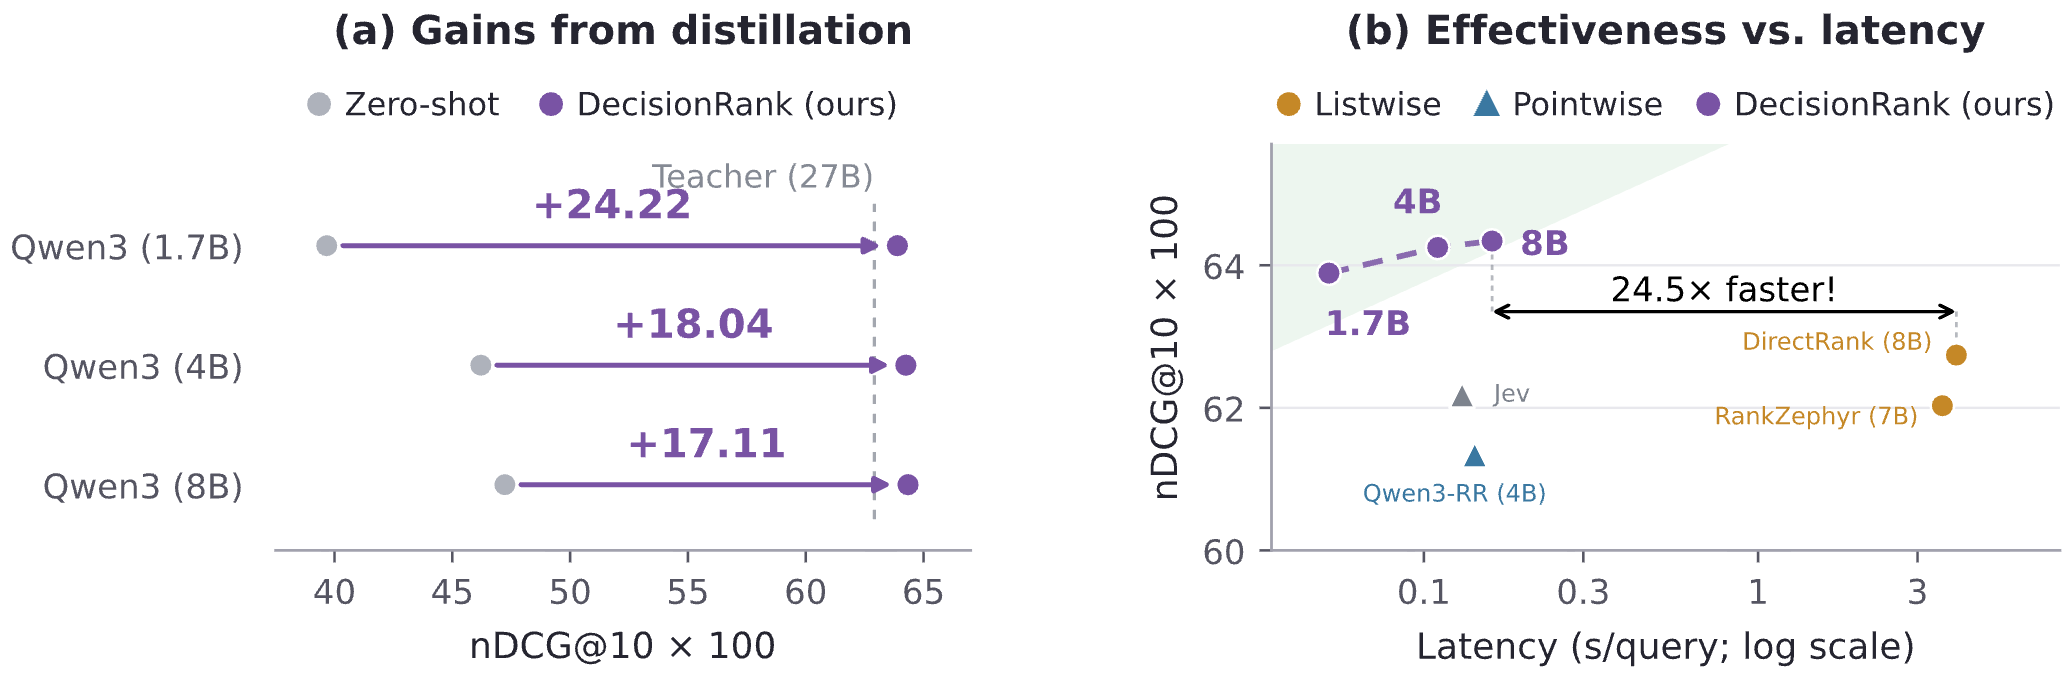
Качество ранжирования и время обработки одного BM25 top-100. Это замер reranker, а не всего RAG. ИсточникМетод, ограничения и следующий шаг
Как устроено. Ученик сортирует оценки первого токена и выбирает top-20. Замороженный генеративный учитель одним teacher-forced проходом оценивает последовательные выборы ученика. Reverse KL сближает распределения оценок документов, а RankNet сохраняет порядок из заранее полученных rankings. После обучения для всех кандидатов нужен один forward pass; учитель и последовательная генерация больше не участвуют.
Основание. По эксперименту авторов. 16 000 training queries; три размера Qwen3-ученика и три семейства учителей. На TREC DL19–23 Qwen3-8B DecisionRank даёт nDCG@10×100 = 64,34 против 62,92 у listwise DirectRank в основной таблице. Заявленные 24,5× на TREC DL и 16,7× на BRIGHT относятся к single-query reranking 100 кандидатов при одинаковом passage limit на B200, не ко всему пути RAG.
Ограничение. Passages обрезаны до 128/384 токенов. В основной таблице у baselines исходные лимиты документов; сравнение с общими лимитами вынесено в приложение. На R2MED DecisionRank-8B уступает listwise DirectRank: 43,55 против 44,50, при общем лимите — 43,55 против 44,10. Замер ученика не включает сортировку; приведённые ускорения не относятся ко всему RAG. Для Jev взята server-reported latency без уравнивания оборудования. Seed-проверки ограничены TREC DL/BRIGHT; калибровка зависит от qrels — разметки релевантности — и не гарантирует верного отдельного решения.
Для моей работы. Мой вывод: для RAG с жёстким бюджетом задержки можно сравнить генерацию rankings с прямой оценкой документов. Согласование обучения и способа чтения оценки также позволяет передавать знания между моделями с разными словарями.
Следующий шаг. На своей разметке проверить обрезку документов и полное время ответа, включая retrieval и сортировку. При обучении сравнить RankNet с совместной целью на фиксированных данных и нескольких seed.
Повторы одного ложного источника мешают проверке RAG-контекста
agents
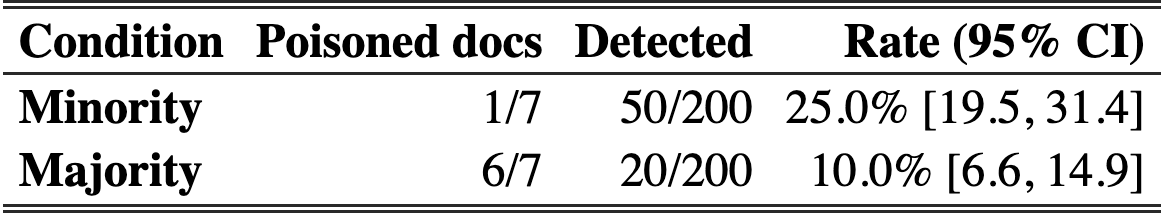
Несколько документов могут повторять одну ошибку и создавать видимость независимого подтверждения. Авторы попросили Gemma-3-12b искать ложный фрагмент в контексте SciFact: когда к нему добавляли пять парафраз, обнаружение падало с 25 до 10 %. Работа ставит вопрос о зависимости источников в RAG; какой именно фактор вызвал падение, эксперимент не изолирует.
Когда один ложный документ дополнен пятью парафразами, обнаружение падает с 50/200 до 20/200. ИсточникМетод, ограничения и следующий шаг
Как устроено. Для одних и тех же 200 вопросов, выбранных с seed 38, сравнили два контекста по семь документов. В первом были один ложный и шесть корректных фрагментов; во втором — исходный ложный фрагмент, пять его парафраз и один корректный. Модель получала одинаковый запрос на структурированный отчёт об ошибках. Парные исходы сравнили точным тестом Макнемара, интервалы долей — методом Уилсона.
Основание. По эксперименту авторов. 25 % = 50/200 против 10 % = 20/200; 15 процентных пунктов. Среди 38 несовпадающих пар 34 потеряли обнаружение и 4 приобрели его. Точный двусторонний тест Макнемара: p = 6,04 × 10⁻⁷. Это явление в фиксированном контексте, а не успешность атаки на retrieval.
Ограничение. Проверена одна Gemma-3-12b в фиксированном контексте; retrieval и конечный ответ не оценивали. Вместе с повторениями менялись доля ложных документов и число корректных возражений, поэтому эффект конформизма не отделён от других причин. Бинарные метки в workbook не подкреплены независимой ручной оценкой всех объяснений.
Для моей работы. Для backend-инженера это основание добавить дедупликацию и отслеживание происхождения в RAG-eval. Это мой вывод о применении; работа не проверяла такой способ защиты и не измеряла качество конечного ответа.
Следующий шаг. В своём наборе отдельно варьировать повторения одного источника и число независимых источников при постоянном числе корректных документов; оценивать и обнаружение лжи, и конечный ответ.
Почему пустой отчёт архитектурного gate ещё не означает PASS
agents
Проверка зависимостей может не увидеть часть файлов и вернуть пустой список нарушений. Авторы предлагают архитектурному gate отдельно проверять полноту наблюдения, конкретные запрещённые связи и право обновить baseline. В эксперименте непроверяемые файлы сохранили UNKNOWN. Подход помогает различать отсутствие нарушения и отсутствие данных для вывода.
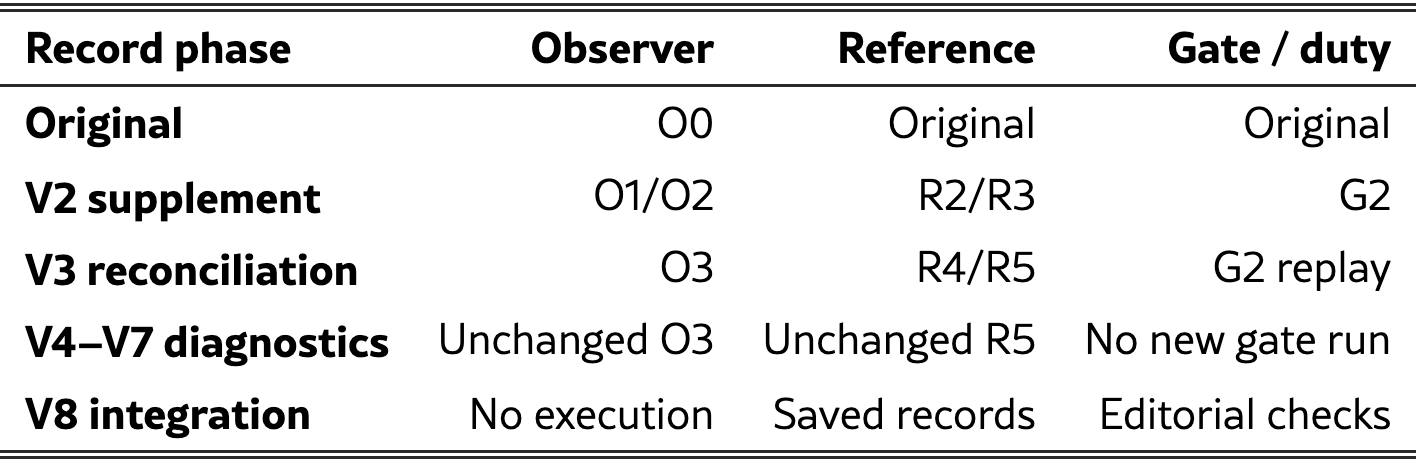
Авторы отделяют исходные запуски от своих последующих проверок и исправлений описания. ИсточникМетод, ограничения и следующий шаг
Как устроено. На четырёх зафиксированных TypeScript/JavaScript-репозиториях автор сравнил наблюдатель зависимостей с отдельной проверкой на Babel/TypeScript. В построенных сценариях одну запрещённую связь заменяли другой или возвращали ранее удалённый долг. Обёртка привязывала свидетельства к текущим исходникам, области проверки, политике и версии baseline. Функциональные замеры и timing ограничены двумя областями пакетов; история провалов и исправлений сохранена.
Основание. По эксперименту авторов. Из 240 файлов 166 прошли условия сопоставления наблюдателя и программного эталона — 69,17 %. В этой подвыборке результаты полностью совпали; для остальных 74 сохранён UNKNOWN. В 480 построенных сценариях и новый подход, и dependency-cruiser совпали со всеми ожидаемыми исходами. Преимущества над dependency-cruiser не показано. Все 120 исходных замеров полного дерева не прошли условия пригодности.
Ограничение. Артефакты закрыты, независимого воспроизведения нет. Программный эталон исправляли после просмотра исходов, а часть предположений о разрешении зависимостей общая с проверяемым инструментом. Сценарии переиспользуют небольшой набор исходных примеров; успешные ограниченные проверки охватывают только две области пакетов. Поведение coding-агентов и продуктивность не оценивали. Защита зависит от доверенных runner, policy и baseline; гарантий распределённого хранения нет.
Для моей работы. Мой вывод: в CI вокруг coding-агента полезно разделить REJECT и UNKNOWN. Хранить конкретные связи, признанные техническим долгом, и проверять, что результат относится к текущим исходникам, области проверки и политике. Это применение ограниченного эксперимента, а не гарантия работы инструмента.
Следующий шаг. Проверить свой dependency gate на два случая: компенсация числа нарушений новой связью и повторное введение уже удалённой связи. Отдельно убедиться, что пропущенный файл или устаревший scan не дают PASS.
Wenbo Ye, Yongxi Zhou, Junwei Yao, Jiahui Ge · · Препринт
После неудачного исправления: сохранить историю или написать урок
agents
Если агент не исправил баг с первой попытки, следующему запуску можно передать историю или короткий урок, написанный моделью. Авторы сравнили оба варианта с обычным retry на Python-дефектах. Урок потребовал лишний вызов и не показал убедительного преимущества над историей; результат зависел и от того, какие тесты считать успехом.
Метод, ограничения и следующий шаг
Как устроено. Для каждой из 75 задач BugsInPy провели по шесть независимых первых попыток gpt-5.4-mini. Затем 181 неудачу повторили из исходного workspace с NONE, HISTORY, REFLECT, SIGNAL и BOTH. История и урок строились по одной усечённой записи, чтобы сравнить именно шаг суммаризации. Применили парное сравнение, bootstrap с группировкой по задаче и поправку Holm. Позже добавили gpt-5.4, контроль с одним уведомлением о неудаче и post hoc анализ полного набора тестов.
Основание. По эксперименту авторов. M1: обычный retry 29,8 % на 181 неудаче; HISTORY +9,4 п. п., REFLECT +7,2, SIGNAL +5,5, BOTH +9,9, ни одно primary различие не значимо после Holm. REFLECT−HISTORY = −1,7 п. п., 95 % CI [−8,7; +4,9]. Оценки полного набора тестов HISTORY +5,0, REFLECT +7,2; все интервалы включают ноль. M2: 85 неудач, REFLECT−HISTORY −3,5 [−14,1; +8,2].
Ограничение. Основные различия M1 после поправки Holm не значимы: работа не доказывает ни отсутствие эффекта, ни равенство стратегий. На полном наборе тестов, выбранном для дополнительного анализа post hoc, REFLECT немного впереди по точечной оценке. Проверены одна семья моделей, короткий harness и pure-Python задачи с большой долей black. Были прерывания и промежуточный просмотр результатов; p-values номинальные.
Для моей работы. Мой вывод: перед добавлением reflection в агент для исправления багов нужно сравнить его с обычным retry и передачей истории при одинаковом бюджете. Отдельно учитывать тест, воспроизводящий баг, полный regression suite и стоимость всей попытки.
Следующий шаг. На своих дефектах сравнить retry, передачу истории и урок. Каждый раз сбрасывать workspace, сохранять лимиты и запускать широкий regression suite. Решение о лишнем вызове модели принимать по этим результатам.
Ira Ceka, Arnav Garg, Ryan Lutz et al. · · Препринт
MetaVul: настраивать harness на validation и проверять на закрытом test
agents
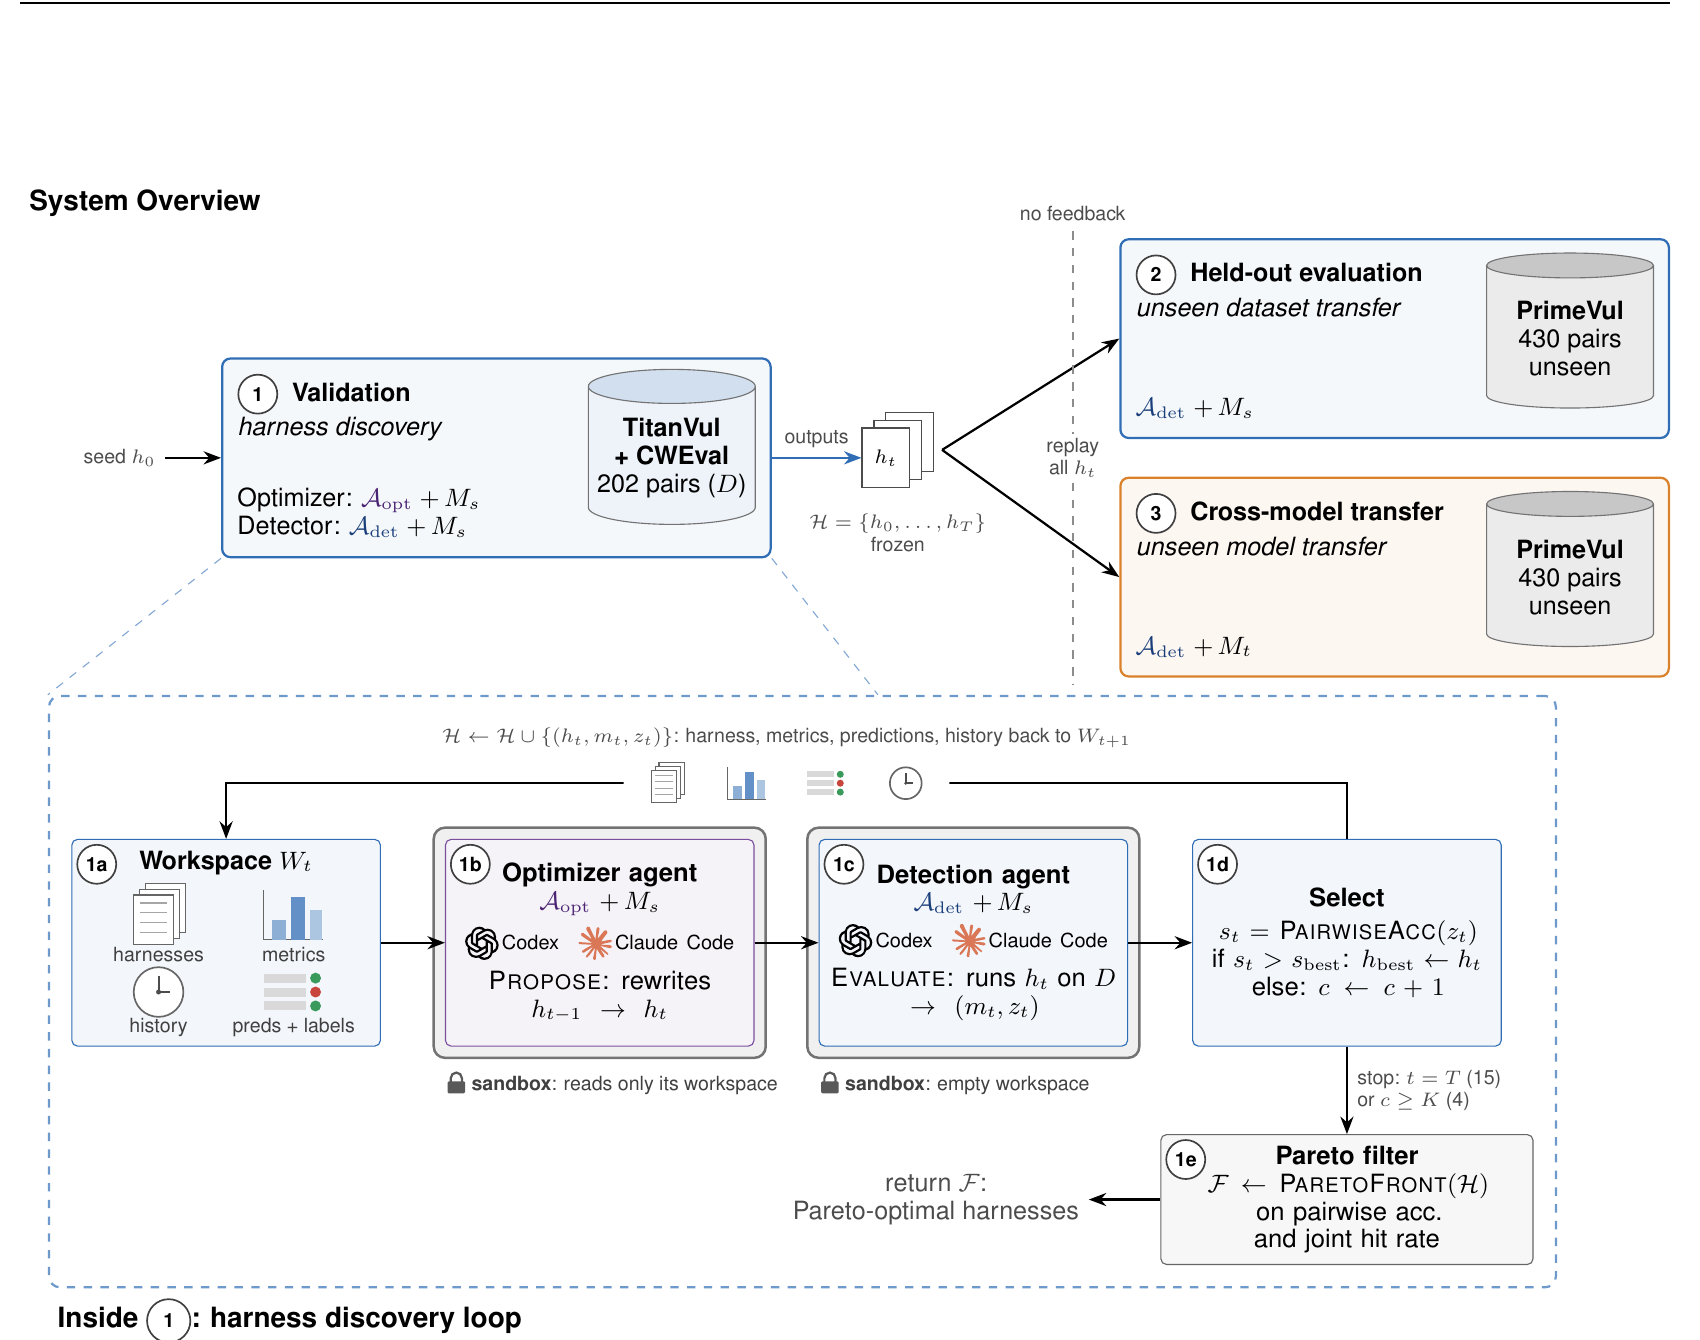
Детектору уязвимостей может мешать способ подачи кода и проверки ответа. В MetaVul агент меняет Python-harness — обвязку детектора — по результатам validation. Тестовый набор скрыт от оптимизатора во время настройки; затем авторы проверяют замороженные варианты на других данных и моделях. Подход показывает, как отделить настройку от оценки переноса; рост точности различения кода и патча здесь сопровождается пропуском части уязвимостей.
MetaVul настраивает harness на validation, затем проверяет замороженные варианты на закрытом PrimeVul. ИсточникМетод, ограничения и следующий шаг
Как устроено. Оптимизатор видит историю harness, метрики и размеченные ответы на 202 парах TitanVul/CWEval. Отдельному детектору доступны только функция и обвязка; PrimeVul закрыт от поиска. После максимум 15 итераций сохраняют Pareto-фронт вариантов по точности различения уязвимой и исправленной функции и попаданию в CWE и строки. Затем их проверяют на 430 парах без пересечений с validation и при переносе между моделями.
Основание. По эксперименту авторов. Валидация: 202 пары, 161 C и 41 C++; тест: 430 пар PrimeVul после удаления 5 пересечений. Прирост 5,6–25,8 п. п. на тесте относится к выбранным вариантам Pareto-фронта и конкретным моделям, не ко всем запускам. Сравнение GPT-4o: 103/435 против 74/435 у seed и 81/435 у VulTrial; после удаления пересечений 100/430 против 71/430. Recall при этом падает.
Ограничение. Проверены отдельные C/C++ функции без контекста репозитория; бюджет ограничивает повторы, итерации и пары моделей. При росте pairwise accuracy падает recall, а локализация улучшается лишь у 10 из 40 harness. Сравнение GPT-4o опирается на результаты других работ и лучший из проверенных переносов, а не на новый запуск всех baselines. Изменённые патчем строки служат приближённой разметкой локализации; попадание публичных наборов в обучение полностью не исключено.
Для моей работы. Мой вывод: при автоматизации security review стоит разделить настройку harness и закрытую оценку, а улучшение precision проверять вместе с пропущенными уязвимостями. Показатель pairwise accuracy полезен для проверки, замечает ли детектор собственно исправление.
Следующий шаг. Собрать небольшой закрытый набор уязвимая функция/патч из своего домена и сравнить исходный и изменённый harness по обеим ошибкам, не давая оптимизатору доступ к контрольным парам.
CodeSpecWeave: проверять, как требования к патчу влияют друг на друга
agents
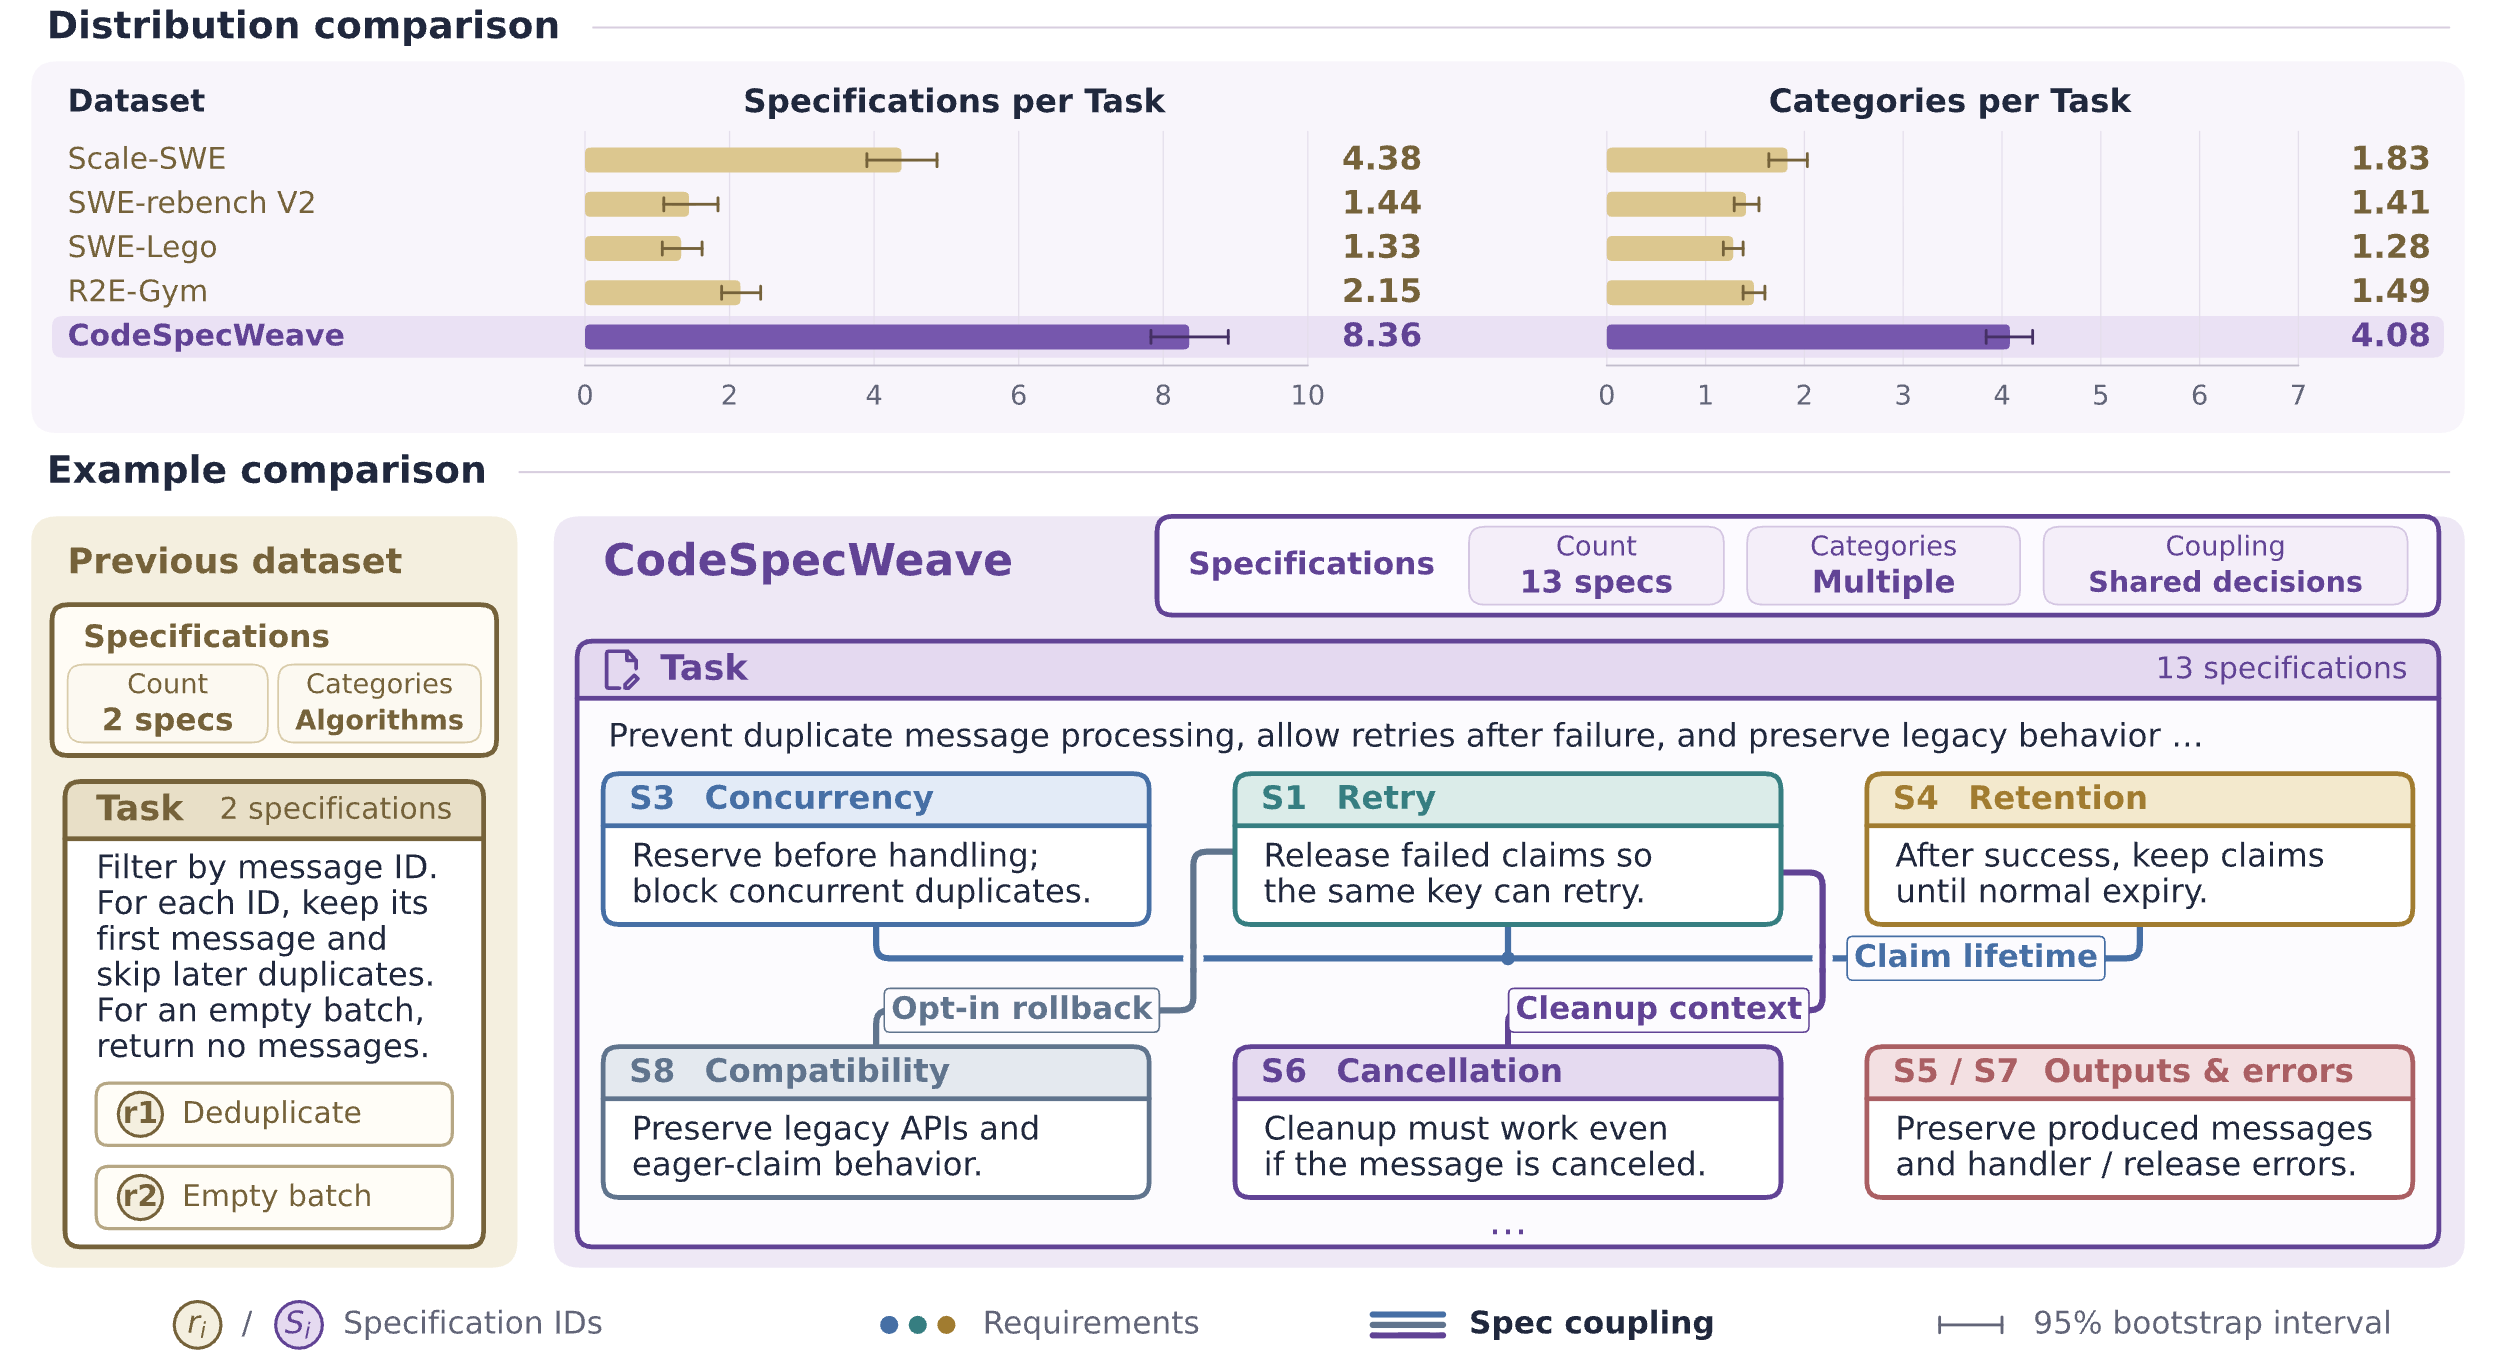
Новое правило API может пройти свой тест и при этом нарушить совместимость или сохранность состояния. CodeSpecWeave создаёт задачи с такими связанными требованиями и проверяет согласованность спецификации, тестов и патча. Работа помогает проектировать coding-evals: тесты должны проверять взаимодействие требований и допускать разные корректные решения.
CodeSpecWeave связывает требования к состоянию, совместимости и ошибкам в одной задаче. ИсточникМетод, ограничения и следующий шаг
Как устроено. Из обсуждений разработчиков и изменений кода извлекают образцы требований. Агент создаёт связанные спецификации и исполняемые тесты в репозитории; другие модели решают задачу. Review-агент сопоставляет запрос, шаги решения, патч и тесты. Получены 4 670 тренировочных задач в 2 865 репозиториях и вручную проверенный benchmark из 100 задач с 1 044 спецификациями. Две базовые модели MiMo дополнительно обучены с GRPO.
Основание. По эксперименту авторов. Benchmark: 100 задач, по три попытки, контекст 512K, temperature 1,0. На DeepSWE-v1.1 MiMo-V2.5 растёт с 12,39 до 25,30%, Flash-SFT — с 54,42 до 62,98%. Это RL-сравнение определённых backbone и датасетов; среднее по четырём benchmark невзвешенное. В пилотных 3 067 кандидатах automated review нашёл проблемы согласования у 73,9%, это не частота ошибок финального benchmark.
Ограничение. Синтетические задачи и ручная проверка авторами не гарантируют полноту проверяющей программы. Модели сравнивают с разными agent harness, а RL проверен на двух родственных MiMo-моделях; условия оценки указаны в «Основании». Более длинные рассуждения и изменения большего числа файлов не доказывают безопасность рефакторинга. У Flash-SFT в первых 40 turns доля повторных циклов edit–test снижается с 47,7 до 45,7 %. Универсального преимущества на SWE-бенчмарках нет: в отдельных столбцах MiMo Coding выше.
Для моей работы. Мой вывод: в backend-evals следует включать совместные сценарии rollback, порядка вызовов и обратной совместимости. Они ближе к рискам реального изменения API, чем отдельные независимые unit-проверки.
Следующий шаг. Взять один свой сценарий с транзакцией и совместимостью API; добавить тест, где удовлетворение нового правила может нарушить сохранность прежнего состояния. Проверить тесты и на альтернативном корректном решении.
Вредные AGENTS.md: объяснение агента и безопасность патча расходятся
agents
Инструкция в AGENTS.md или CLAUDE.md может советовать агенту отказаться от защитной проверки. Авторы поместили такие файлы в C/C++-репозитории и отдельно оценили код и объяснение агента. Упоминание атаки не гарантировало безопасный патч. Влияние на долю безопасных решений осталось неопределённым; работа показывает, зачем проверять код независимо от итогового сообщения.
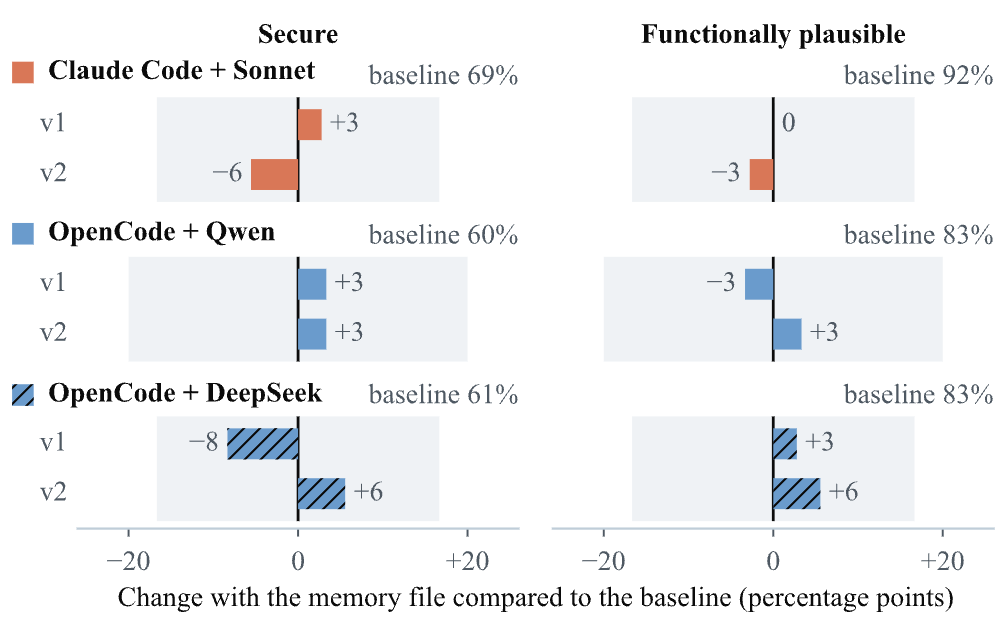
Сдвиги безопасности и функциональности малы и разнонаправленны; они остаются в диапазоне случайности. ИсточникМетод, ограничения и следующий шаг
Как устроено. На 36 задачах SecRepoBench сравнили запуск без memory-файла с двумя версиями вредных инженерных советов. Claude Code/Sonnet 5.5 и OpenCode с Qwen 3.8 27B или DeepSeek V4.1 Flash запускали по одному разу на режим. Безопасность проверяли sanitizer/OSS-Fuzz PoC, функциональность — тестами, проходящими на эталонном исправлении. Упоминания файла в рассуждениях и финальном сообщении оценивали вручную.
Основание. По эксперименту авторов. Сдвиг security от −8 до +6 п. п., без согласованного направления. Среди 204 пар 30 расходятся по security: по 15 в каждую сторону; одна попытка не отделяет воздействие от случайности.
Ограничение. Выбраны быстрые C/C++ задачи: 12 CWE и 15 репозиториев. На задачу и режим получен один ответ, повторяли только после сбоя сессии; шесть Qwen-задач исключены из-за неполных результатов. PoC проверяет одну целевую слабость, функциональные тесты не доказывают безопасность. Сводку рассуждений Claude нельзя напрямую сравнивать с полной записью OpenCode; данные доступны по запросу. Малый и разнонаправленный эффект не доказывает безвредность memory-файлов.
Для моей работы. Моя рекомендация: проверять изменения project-memory как код и запускать отдельные security-тесты патча. Работа не проверяла эффективность конкретного фильтра инструкций.
Следующий шаг. Добавить видимый diff инструкций к review agent-патча; проверить, что security-тесты запускаются независимо от итогового объяснения агента.
Wesley K. G. Assunção, Ramesh Periyathambi · · Препринт
CASE: какой код применим к нужному региону и rollout
agents
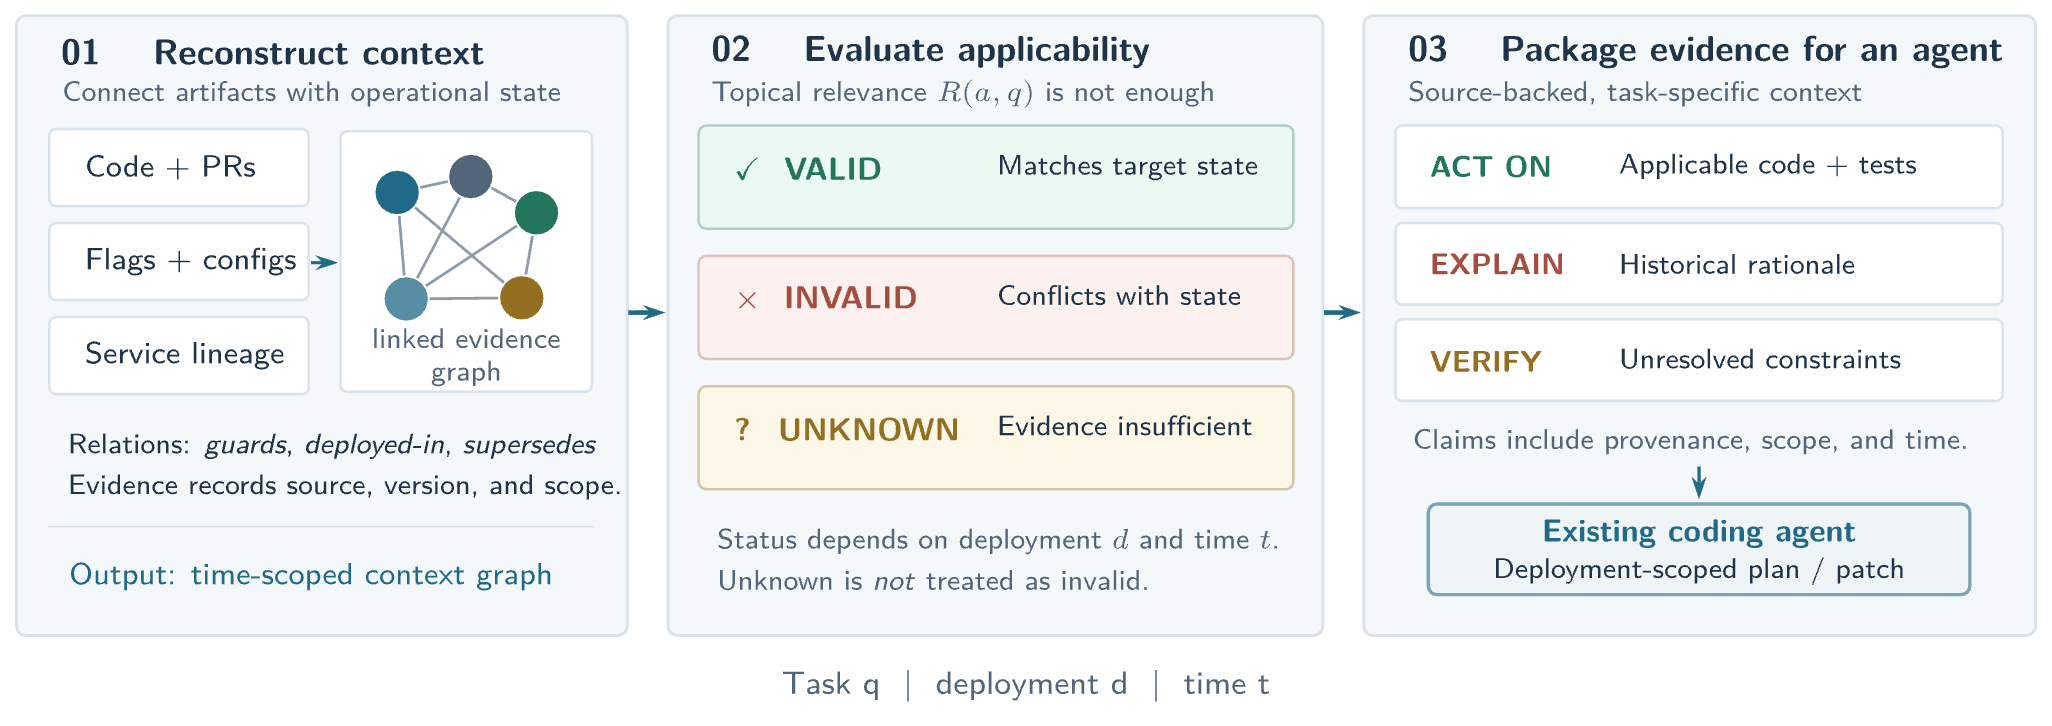
После регионального rollback старый REST-путь может быть правильным, хотя поиск находит новую GraphQL-ветку. CASE предлагает учитывать deployment при сборе контекста: связывать код с флагами и миграциями, а затем разделять сведения на применимые к целевой конфигурации, несовместимые и пока не проверенные. Прототип показывает устройство такого отбора; улучшение реальных патчей ещё не проверено.
CASE проверяет применимость контекста к deployment и разделяет valid, invalid и unknown. ИсточникМетод, ограничения и следующий шаг
Как устроено. Прототип хранит версии артефактов, флагов, deployment и миграций в графе. Каждое предписание получает область действия, время и происхождение. В примере merchant-trust BM25 выбирает общий пул top-eight; четыре стратегии и две абляции отбирают контекст при близком бюджете 1 500 токенов. Измеряют применимость контекста к deployment, а не код агента.
Основание. По эксперименту авторов. В шести синтетических задачах semantic-only показывает 16 несовместимых и 5 неизвестных артефактов как actionable. CASE исключает их; без flags recall падает до 0,13. Метрики следуют авторским reference-rules.
Ограничение. Синтетический пилот содержит 15 артефактов, три deployment и шесть задач. Связи и условия применимости заданы вручную; эталонная разметка следует тем же правилам, что CASE. Поэтому precision/recall 1,00 не дают независимой проверки или доказательства переноса на другие системы. Удаление lineage-связей не меняет результат, стоимость поддержки свидетельств не измерена.
Для моей работы. Мой вывод: для backend с feature flags агенту можно передавать целевой регион, cohort и состояние rollout. Если применимость не установлена, сохранять unknown вместо догадки. Это адаптация идеи, а не гарантия корректного изменения сервиса.
Следующий шаг. На своей миграции собрать два пакета контекста для разных deployment. Вручную проверить, что историческое объяснение не превратилось в указание использовать уже неактивный путь.
Saiful Khan, Yiwen Xing, Joyraj Chakraborty, Afrah Farea, Philip Beaucamp, Samuel Jackson, Min Chen · · Препринт
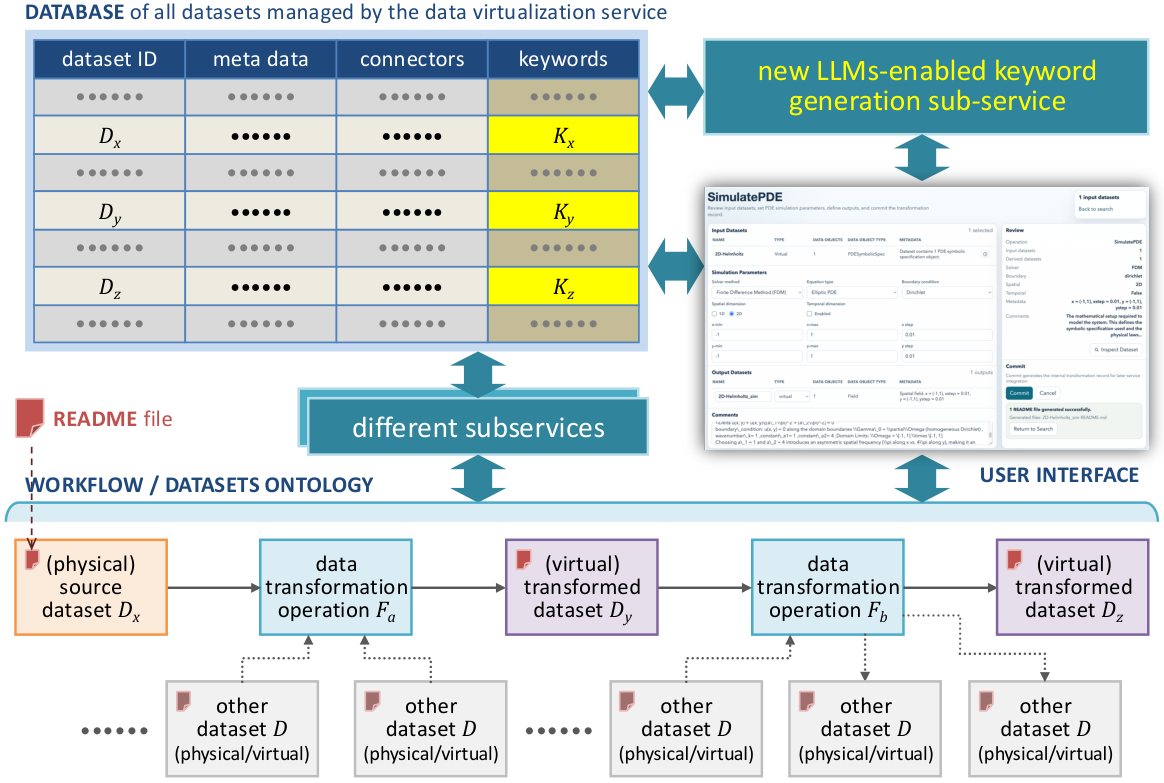
Как добавить поисковые теги к производным датасетам
agents
У производного датасета может быть мало собственного описания, хотя его назначение понятно из исходных данных и преобразований. Авторы используют эту связь: сервис генерирует теги из README, метаданных родителей и описания workflow, затем добавляет их в индекс. Это пример организации каталога данных; качество поиска и скорость индексирования в рабочем потоке ещё требуют проверки.
Новый датасет получает поисковые теги из собственного описания и графа происхождения. ИсточникМетод, ограничения и следующий шаг
Как устроено. При регистрации датасета KGS обходит граф его происхождения в топологическом порядке и собирает один из пяти вариантов контекста. Локальная модель возвращает JSON-массив из 6–10 тегов. Сервис проверяет ответ, сохраняет теги в узле графа и индексирует их вместе с метаданными в vector database. Авторы сравнивают три генератора с YAKE, TF-IDF и KeyBERT при двух embedding-оценщиках.
Основание. По эксперименту авторов. 38 датасетов, пять workflows, три генератора: Gemma3 27B, Llama3.2 3B и Mistral 7B; два embedding-оценщика. Таблица III: semantic F1 Gemma3 — 0,749 с Qwen и 0,532 с MiniLM, случайный уровень — 0,633/0,307, после пересчёта — 0,30/0,29. YAKE: 0,705/0,422. R@5 для одних метаданных — 0,618 против 0,132 случайного поиска; R-precision ниже 0,30.
Ограничение. Поисковые запросы получены из той же экспертной разметки ключевых слов, поэтому результат не описывает реальный пользовательский поиск. Throughput, p95, очереди и операционная стоимость не измерены. R-precision ниже 0,30: выдачу следует рассматривать как список кандидатов. Семантический F1 зависит от embedding-оценщика и высокой оценки случайного совпадения. Для YAKE используем таблицу III: значение 0,705 для обоих оценщиков в авторском тексте ей противоречит.
Для моей работы. Мой вывод: при регистрации датасета можно дополнять описание сведениями о его происхождении и отдельно версионировать этот контекст. Качество нужно проверять по поиску нужных данных, а не только по сходству тегов с экспертной разметкой.
Следующий шаг. На своём каталоге сравнить теги из одного README и теги с учётом родителей. Проверить поиск на независимых пользовательских запросах и измерить очередь, стоимость и задержку индексирования.
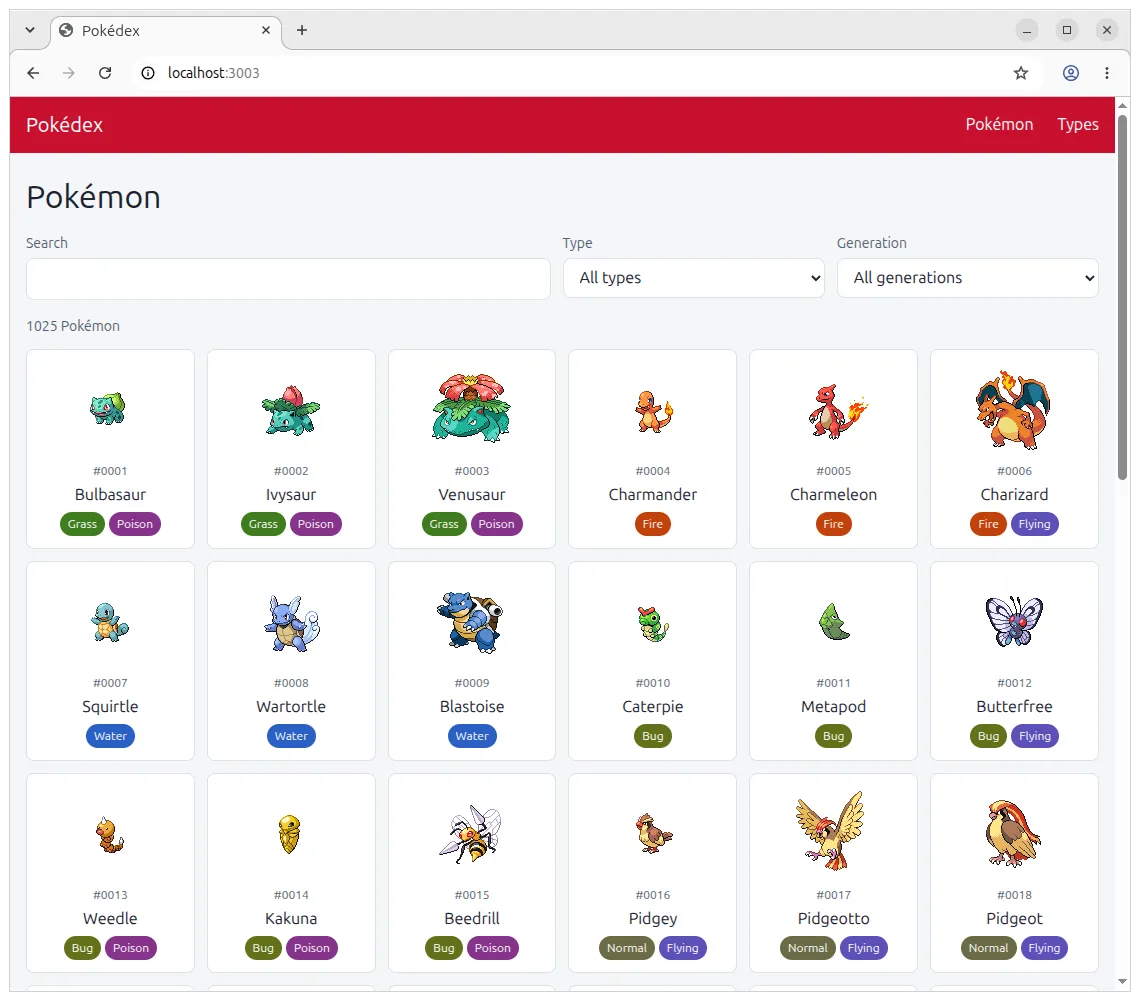
Сколько стоит агенту собрать одно приложение на разных JavaScript-стеках
backend
Выбор frontend-стека влияет и на работу coding-агента. Nolan Lawson поручил Opus 5.5 собрать одно Pokémon-приложение на двенадцати JavaScript-стеках, затем сравнил стоимость, время, код и Lighthouse. Для собственного сравнения пригодится устройство эксперимента: общая спецификация, проверки результата и повторные запуски. Рейтинг одного приложения переносить на другой продукт рано.
Одно Pokémon-приложение с общей спецификацией — задача для сравнения двенадцати JavaScript-стеков. ИсточникМетод, ограничения и следующий шаг
Как устроено. Для каждого стека автор сделал пять сборок в sandbox и предоставил официальные MCP или skills, если они существовали. Общие conformance-тесты проверяли приложение через accessibility-tree. Агент не знал о последующем Lighthouse на mobile-профиле с ограничениями CPU и сети. Стоимость учтена по всем попыткам; качество и размер кода Angular измерены только у трёх успешных приложений.
Основание. По описанию и примерам автора. Hono+htmx: медиана $2,67 против Angular $4,97; диапазоны соприкасаются в $3,19. Angular: две из пяти сборок не дали измеримого приложения; стоимость включает их, performance — нет.
Ограничение. Одна модель Opus 5.5 high, небольшое контентное приложение и Chromium/mobile Lighthouse на заданном ноутбуке. Выбранные метрики благоприятствуют MPA — многостраничным приложениям. Использование MCP/skills различалось, архитектуру SSR/CSR не фиксировали. Выборки стоимости и performance различаются из-за неуспешных сборок Angular. Долларовые суммы — API-оценка Claude Code при подписке автора, а не плата за каждый запуск. Число строк не измеряет поддерживаемость.
Для моей работы. Мой вывод: для интерфейса, который пишет агент, можно сравнивать стеки по стоимости всех попыток и качеству полученного приложения. Результат этого теста не даёт универсальной рекомендации Hono или Astro.
Следующий шаг. Взять свою типовую задачу и сравнить два стека на нескольких повторах, фиксируя версию модели, тесты и стоимость неуспешных попыток.
Когда поток найденных багов упирается в review и backport
backend
LLM могут находить дефекты быстрее, чем команда успевает проверить и перенести исправления в старые ветки. Robert Haas описывает эту нагрузку в PostgreSQL и связывает её с задержкой версии 19. Это опыт участника проекта, подкреплённый сравнением коммитов. Он помогает увидеть возможное узкое место процесса, но не измеряет причинный эффект AI.
Метод, ограничения и следующий шаг
Как устроено. Автор сравнил коммиты между feature freeze 8 апреля и 25 сентября в 2025 и 2026 годах: отдельно master, stable-ветку нового релиза и предыдущего. По опыту участия он связывает поздние откаты функций и задержку релиза с исправлением дефектов и отвлечением review на старые ветки.
Основание. По описанию и примерам автора. В stable-ветке нового релиза за сопоставимый период 724→1169 коммитов (+61,5 %, более 60 %). Для предыдущего релиза — 248→433 (+74,6 %, более 74 %). Это разные ветки соседних лет, а не оценка причинного эффекта LLM.
Ограничение. Число коммитов не измеряет время поиска, review и исправления. Происхождение каждого сообщения о баге не размечено, контрольной группы нет. Сравниваются разные stable-ветки соседних релизных циклов, поэтому рост не доказывает влияние LLM. Прогноз даты релиза — мнение автора на момент статьи. Текст перепечатан из Neon; дата исходной публикации в сохранённой странице отсутствует.
Для моей работы. Мой вывод: в команде нужно измерять весь цикл — долю подтверждённых сообщений, время воспроизведения, очередь review и backport. Рост числа находок может увеличить нагрузку, не ускорив доставку.
Следующий шаг. Для сообщений агента требовать минимальное воспроизведение и подтверждённый симптом. Отдельно наблюдать время человеческого review и очередь исправлений для старых веток.
Bobo Li, Jiajia Song, Hao Fei, Wynne Hsu, Mong Li Lee · · Препринт
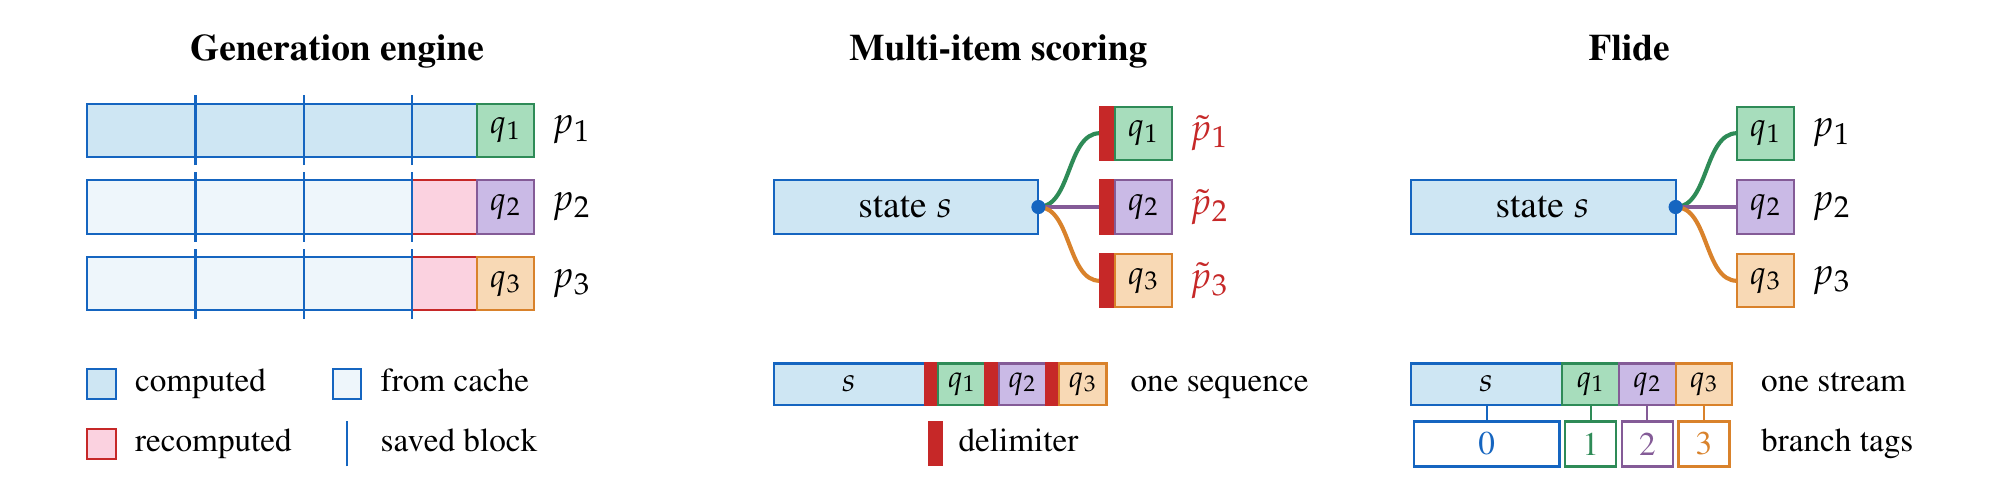
Flide: общий проход модели для нескольких проверок одной истории
agents
Для маршрутизации или guardrails одна длинная история часто требует нескольких коротких ответов. Flide обрабатывает общий контекст один раз, затем исполняет вопросы в отдельных ветвях, сохраняя вычисления изолированного запроса. Это способ сократить повторную работу модели; он рассчитан на категориальные ответы и поддерживаемые архитектуры, а не на произвольную генерацию текста.
Flide делит общий контекст между ветвями вопросов, сохраняя вычисление отдельного запроса. ИсточникМетод, ограничения и следующий шаг
Как устроено. ForkAttention хранит зависимости запросов в GPU metadata и исполняет токены одним плоским потоком. Каждая ветвь attention видит общий контекст и только свои токены; в Gated DeltaNet она получает точное состояние общего контекста. CUDA graphs переиспользуются по длине потока, checkpoint позволяет продолжить растущую историю. Дополнительный batch-invariant режим фиксирует порядок сложения floating-point значений на том же оборудовании и ПО.
Основание. По эксперименту авторов. Таблица 3: шесть публичных workloads, Qwen3.5 и Gemma 4, один H200, 1/8/32/64 closed-loop clients. До 9,5× ниже latency относительно лучшего vLLM/SGLang baseline наблюдается при множестве вопросов на одно состояние, а не на любом запросе. Appendix E: invariant-режим теряет не более 10% throughput на 64 clients в проверенных конфигурациях.
Ограничение. Ускорение до 9,5× получено на конкретных задачах с множеством вопросов к одному состоянию. Для одного вопроса под нагрузкой результат может лишь совпадать с baseline. Сравнение ограничено одним H200; у SGLang другой template, а в MIS отключены CUDA graphs и cache. Сохранение математического вычисления не гарантирует побитового совпадения: для этого нужен отдельный invariant-режим с затратами throughput.
Для моей работы. Мой вывод: несколько guardrail-проверок одной истории можно попробовать исполнять совместно, сохраняя изоляцию вопросов. Простая склейка через delimiter меняет вероятности и способна переключить управляющее решение через заданный порог.
Следующий шаг. В своём decision endpoint сравнить вероятности отдельных и совместных запросов, число пересечений порога и latency. Сначала проверить поддержку модели, затем повторить нагрузку с реальным числом вопросов к одной истории.
Mehil B Shah, Mohammad Masudur Rahman, Foutse Khomh · · Препринт
AIFaultBench: реальные AI-дефекты с условиями воспроизведения
agents
Для проверки debugging-агента нужен дефект, который можно воспроизвести в известной среде. AIFaultBench собирает 770 реальных дефектов из 105 AI-репозиториев: исходное сообщение, версию кода, setup, команду запуска и ход расследования. Авторы воспроизвели 652 дефекта; причины остальных неудач тоже сохранены. Набор помогает проверять диагностику и понимать, где ей мешает окружение.
Отбор сообщений о сбоях, попытки воспроизведения и упаковка свидетельств в AIFaultBench. ИсточникМетод, ограничения и следующий шаг
Как устроено. Из активных Python-репозиториев GitHub авторы сформировали пул закрытых issues, выбрали 1 000 кандидатов и оставили 770 содержательных сообщений о сбоях. На каждый дали до трёх часов ручного воспроизведения и повторяли запуск трижды с фиксированными условиями. Успех требовал совпадения ошибки при crash либо отклонения численного проявления не больше 5 %. Индексы и каталоги связывает единый bug_id.
Основание. По эксперименту авторов. 770 дефектов, 105 репозиториев, 76 организаций; 652/770 = 84,7 %. Из 118 не воспроизведённых 46 упёрлись в недоступные ресурсы, 72 — в отсутствие симптома, version drift или nondeterminism. Все успешные симптомы проверяли тремя повторениями; лимит расследования — три часа на дефект.
Ограничение. 652/770 — результат авторов в зафиксированных условиях, здесь он независимо не воспроизведён. Отбор смещён к популярным активным Python-репозиториям и подробным публичным сообщениям, поэтому частоту сбоев по нему оценить нельзя. Исторические зависимости могут стать недоступны. Воспроизведение симптома ещё не подтверждает правильность исправления.
Для моей работы. В своём проекте можно выбрать записи с reproducible=true и подходящим классом системы для проверки debugging-агента. Формат набора также подходит для описания инцидента: версия, среда, команда, исход и причина блокировки. Это рекомендация редакции.
Следующий шаг. Выбрать несколько инфраструктурных или agentic дефектов, изучить setup и reproduction_trajectory, затем воспроизвести в одноразовой среде и добавить отдельные проверки поведения после исправления.
Elizabeth Gilbert, Chris Fallin, Heather Miller, Ben L. Titzer · · Препринт
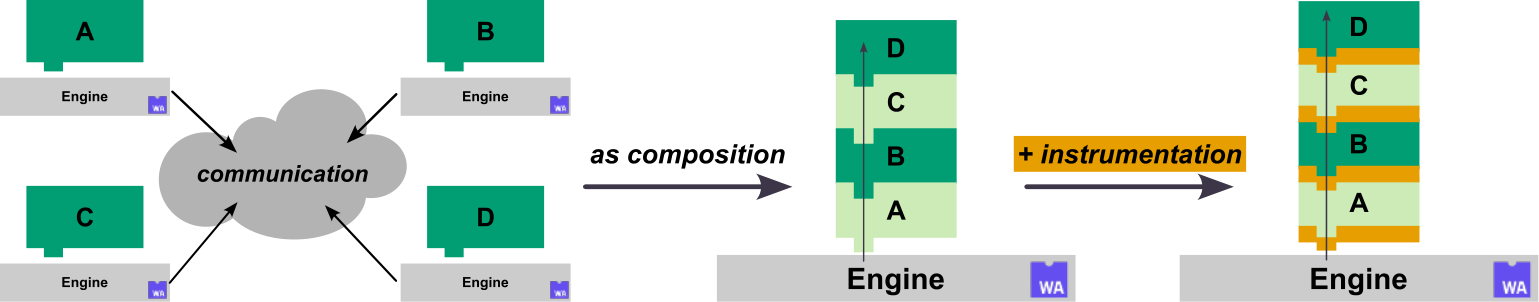
Splicer: наблюдать и менять вызовы между Wasm-компонентами
agents
Если логирование или проверку данных нужно добавить сразу к нескольким Wasm-компонентам, менять каждое приложение неудобно. Splicer вставляет инструмент на типизированную границу вызова: он может записывать, воспроизводить или изменять передаваемые данные. Работа даёт архитектурный вариант для изолированных инструментов; применение к AI-агентам потребует отдельной проверки.
Splicer собирает Wasm-компоненты и вставляет инструмент на границе вызова. ИсточникМетод, ограничения и следующий шаг
Как устроено. Framework восстанавливает граф связей из бинарного Wasm-компонента, применяет YAML-правила к связям и генерирует адаптеры. Типы задаёт WIT — описание интерфейсов компонентов. Четыре уровня доступа позволяют видеть имена вызовов, читать данные, менять их или полностью заменять вызываемую сторону. Инструменты на Rust, Go и JavaScript проверены на WIT-микротестах и Wasm-порте Go DeathStarBench Hotel Reservation: измерены связывание, размер кода и затраты исполнения.
Основание. По эксперименту авторов. Стенд: два Xeon Platinum 8168, 96 ядер, 384 GiB RAM. DeathStarBench: 75% чтения, 20% записи, 5% авторизации; saturation определяется как <90% целевого RPS. Native Go насыщается при 8 000 RPS, Wasm/TCP при 2 500, ABI-композиция не насыщается при 12 000. Это сравнение разных коммуникационных архитектур; single-process композиция требует больше памяти.
Ограничение. Работа посвящена Wasm-инструментации, поведение AI-агентов не проверено. Tiers 3–4 доступны только на Rust и не поддерживают дополнительные host imports. Отражение resource methods неполное: часть вызовов возвращённых handles невидима. Перенос контекста в tiers 1–2 требует внешнего процесса. DeathStarBench изменён и запущен на localhost; замена TCP на ABI внутри процесса меняет архитектуру. Поэтому 12 000 RPS нельзя приписывать одной инструментации или переносить на сетевой production. Независимого запуска здесь нет.
Для моей работы. Мой вывод: Splicer можно изучить как границу исполнения агентных инструментов с типизированными политиками доступа. Для этого нужна компонентная Wasm-архитектура; обычному сетевому сервису такой слой сам по себе не заменит наблюдаемость.
Следующий шаг. В своём небольшом Go/Wasm-компоненте проверить tracing имён вызовов и recorder с доступом только на чтение. Измерить p50/p99 и стоимость копирования данных относительно варианта без промежуточного инструмента.
Decisions API: направить обращение в очередь или передать человеку
backend
Маршрутизатор поддержки должен переживать отказ модели и непригодный ответ, даже если HTTP-запрос завершился успешно. Cookbook показывает этот путь: Decisions API выбирает одну из четырёх очередей, parser проверяет результат, а при отказе или непригодном ответе обращение уходит в human_review. Это пример устройства маршрутизатора на десяти банковских сообщениях; производственную точность он не измеряет.
Метод, ограничения и следующий шаг
Как устроено. Python 3.10+ notebook отправляет POST /v1/decisions в gpt-6-luna с инструкцией и описаниями очередей. Сообщение клиента передаётся отдельно от правил маршрутизации. Parser проверяет тип ответа, имя вопроса, допустимую очередь и диапазон confidence. При отказе или неверном ответе он возвращает None, а приложение назначает human_review.
Основание. По описанию и примерам автора. Каждый полный запуск делает десять оплачиваемых запросов, а не один batch API вызов. Timeout 30 секунд, redirects запрещены, автоматических retries нет; замер включает установку соединения и сеть. Пример confidence 0,92 и probabilities в ответе иллюстративен, это не зарегистрированный результат.
Ограничение. Пример ограничен gpt-6-luna и четырьмя очередями. Для незнакомых интентов нужно добавить other или проверку области применения. Десять сообщений BANKING77 демонстрируют workflow; заявленные в API guide около 10× ускорения notebook не проверяет. Confidence не гарантирует правильный ответ и не заменяет калибровку на своих данных. Код и API здесь не запускались.
Для моей работы. Мой вывод: request builder и parser должны использовать один набор допустимых значений, а отказ должен иметь отдельный исход. Порог confidence для ручного разбора следует выбирать по размеченным обращениям, а не принимать как готовый SLA.
Следующий шаг. В своём проекте задать очереди и исход other либо проверку области применения. На размеченной выборке выбрать порог ручного разбора. До автоматического назначения тикетов проверить отказы и непригодные ответы.