Безопасность памяти, перенос контекста, стоимость coding-агентов и границы измерений. Двадцать материалов о том, как оценивать полный инженерный результат: от найденного свидетельства до проверенного изменения.
Найдено: 20
Ничего не найдено. Попробуйте другой запрос или сбросьте фильтры.
Исследования
Yuzhe Liu, Haolin Tian, Tonghan Wang · · Препринт
ACCT: перенос KV-кэша между моделями требует считать полный путь
agents
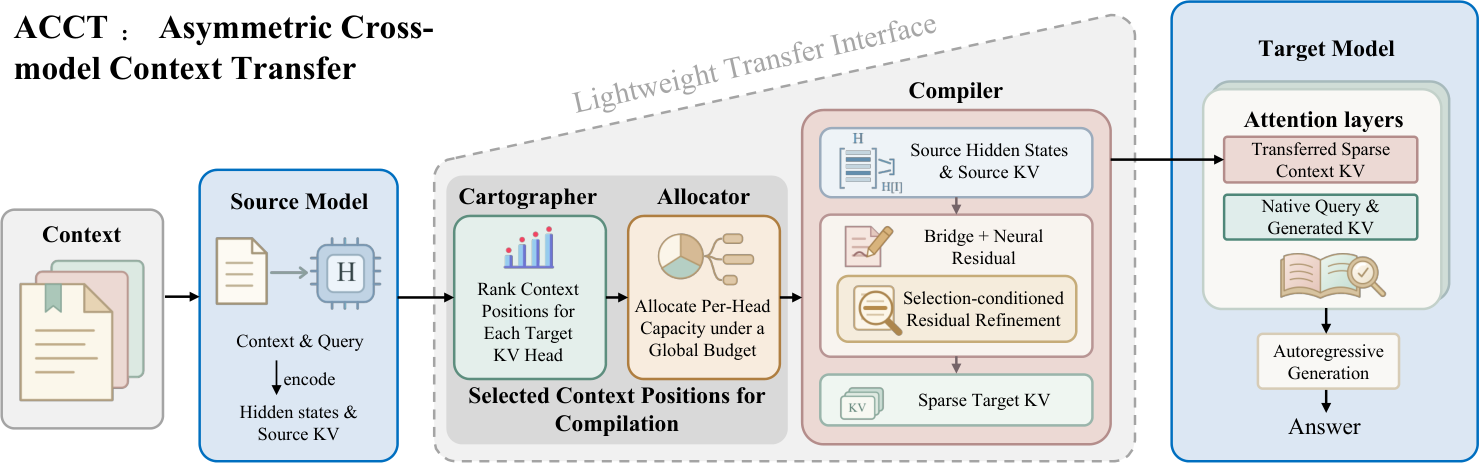
ACCT переносит вычисленный контекст между моделями разного размера внутри одного семейства. Три обучаемых компонента выбирают позиции, распределяют бюджет и строят KV-кэш целевой модели. Это полезная архитектурная идея для маршрутизации запросов, но ускорение конвертации нельзя читать как ускорение всего запроса: качество заметно зависит от направления переноса и задачи.
Перенос контекстных состояний между моделями через обучаемый интерфейс. ИсточникМетод, ограничения и следующий шаг
Как устроено. Авторы замораживают обе модели и обучают отдельный интерфейс для каждого направления. Cartographer ранжирует позиции под запрос, Allocator распределяет четверть исходных KV-слотов, Compiler преобразует состояния. Проверка охватывает шесть направлений Qwen3, Llama и Qwen2.5 и фиксированные 10 000 примеров на одиннадцати наборах; контроль — нативный полный контекст той же целевой модели.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. Основная оценка — 10 000 одинаковых примеров, 11 наборов, 6 направлений; BF16/SDPA, batch size 1, восемь контекстов на направление, ~1K–19K токенов. Медианы стадий на A800 80GB. Target Full — reference, не matched baseline DroidSpeak/C2C. Source encoding включён только в отдельной таблице 15, где target query/generation также исключены.
Ограничение. Это препринт авторов без независимого воспроизведения. Совместимые token-to-ID mappings и отдельно обученный интерфейс обязательны. 6,5–21,2× относится к conversion уже имеющихся source states против target prefill, а не к end-to-end inference. С исходным prefill прямые направления на ~19K токенов дают 1,16–3,35× для построения состояний; target query encoding и генерация всё равно исключены. Главная таблица уже показывает значительные потери в некоторых задачах, дополнение — ниже 1 % на нескольких задачах 14B→4B.
Для моей работы. При проектировании маршрутизатора между моделями можно рассматривать контекст как повторно используемое вычисление. Практический вывод редактора — измерять стоимость построения состояний отдельно от задержки полного ответа и не усреднять провалы по задачам.
Следующий шаг. Пока наблюдать за воспроизводимой реализацией; для собственного эксперимента выбрать одну совместимую пару, сравнить полный latency budget и качество на целевых задачах.
Прежде чем масштабировать поиск, проверьте, есть ли что выбирать
agents
Аудит Cosmos Policy в RoboCasa показывает, почему одной успешности недостаточно для оценки test-time compute. Авторы отдельно проверяют различимость кандидатов, задержку полного запроса и целостность симулятора. Обученный селектор проиграл случайному, сокращение FLOPs дало скромное ускорение, а мощность части экспериментов оказалась недостаточной. Это метод проверки предпосылок, а не общий приговор планированию.
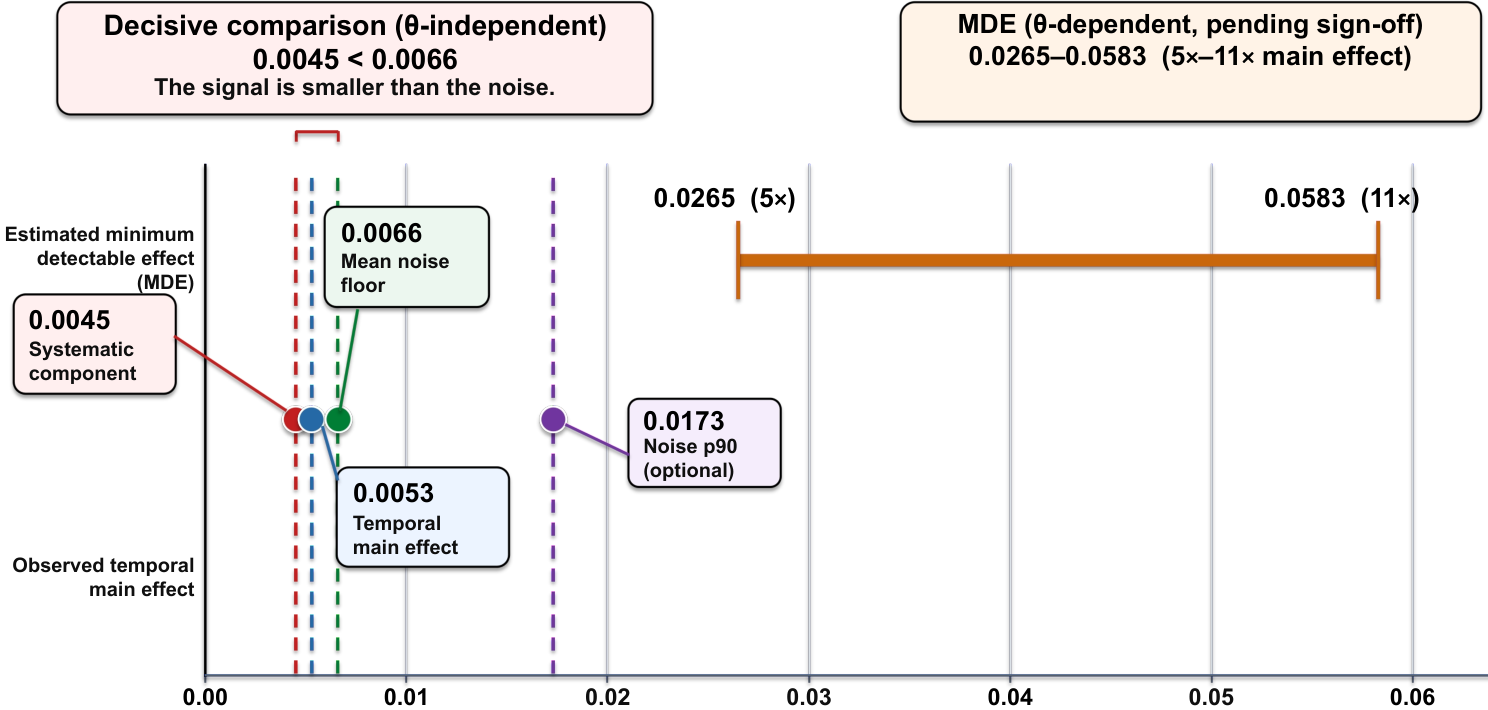
Шум измерения ограничивает обнаружение небольших ускорений; сравниваются разные протоколы измерений. ИсточникМетод, ограничения и следующий шаг
Как устроено. Для восьми кандидатов авторы используют snapshot replay с одинаковым продолжением, два повтора и hindsight oracle как недоступную в эксплуатации верхнюю оценку. Измеряют полный eager-запрос с реальным pruning overhead и отдельно включают framebuffer sentinel. Предварительный power gate останавливает факторный эксперимент, если ожидаемая точность измерения не позволяет различить заранее заданные исходы.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. 263 состояния, N=8 и R=2 в selection audit: value −1,66 п. п.; oracle +1,40 п. п., episode bootstrap CI [−0,25; +3,40]. RTX A6000, bf16, batch 1, 5 denoising steps, 30 timed queries/cell: −47,9% per-forward FLOPs даёт 1,152× deployed speedup (не 15,2% сокращения latency: фактически ~13,2%). В тексте supplement есть неточность формулировки процента wall-clock; использовать speedup из таблицы.
Ограничение. Один Cosmos Policy–RoboCasa стек. Selection audit: четыре задачи, три эпизода, 263 состояния, восемь кандидатов и два повтора; oracle +1,40 п. п. имеет episode-bootstrap CI [−0,25; +3,40] и не даёт надёжного потолка. Pruning — latency-only: качество действий не проверено. Power gate по 16 состояниям не пройден, threshold calibration ожидает sign-off; adaptive allocation остаётся inconclusive. До 65 % rendering corruption относится к нестандартному compute-heavy planning. Supplement ошибочно называет 1,152× ускорение 15,2 % сокращением wall-clock; следует сообщать 1,152× (1254,9→1088,9 мс). В тексте official-corruption расходятся знаменатели 8/200 и 8/1200: процент 0,67 % лучше не цитировать как независимо проверенную частоту.
Для моей работы. Метод переносим на backend-агентов как редакторский вывод: перед дорогим поиском проверить разнообразие полезных исходов, отдельно измерить полный путь и валидность среды. Это помогает отличить слабый селектор от отсутствия сигнала и инфраструктурного артефакта.
Следующий шаг. Для собственного best-of-N сначала сравнить random, deployable selector и oracle на одинаковом пуле; зафиксировать единицу bootstrap и бюджет, затем решить, нужен ли полный запуск.
ArchOR: структурный поиск навыков полезен вместе с правом сохранить baseline
agents
ArchOR выбирает навыки оптимизационного моделирования по структуре задачи, а не только по похожим словам. Улучшенная геометрия поиска и явные сигнатуры помогают найти нужный workflow, но обязательная замена старого маршрута ухудшает результат. Полезный инженерный вывод — отдельно оценивать retrieval и решение об override, сохраняя базовый путь при неполном покрытии сигнатур.
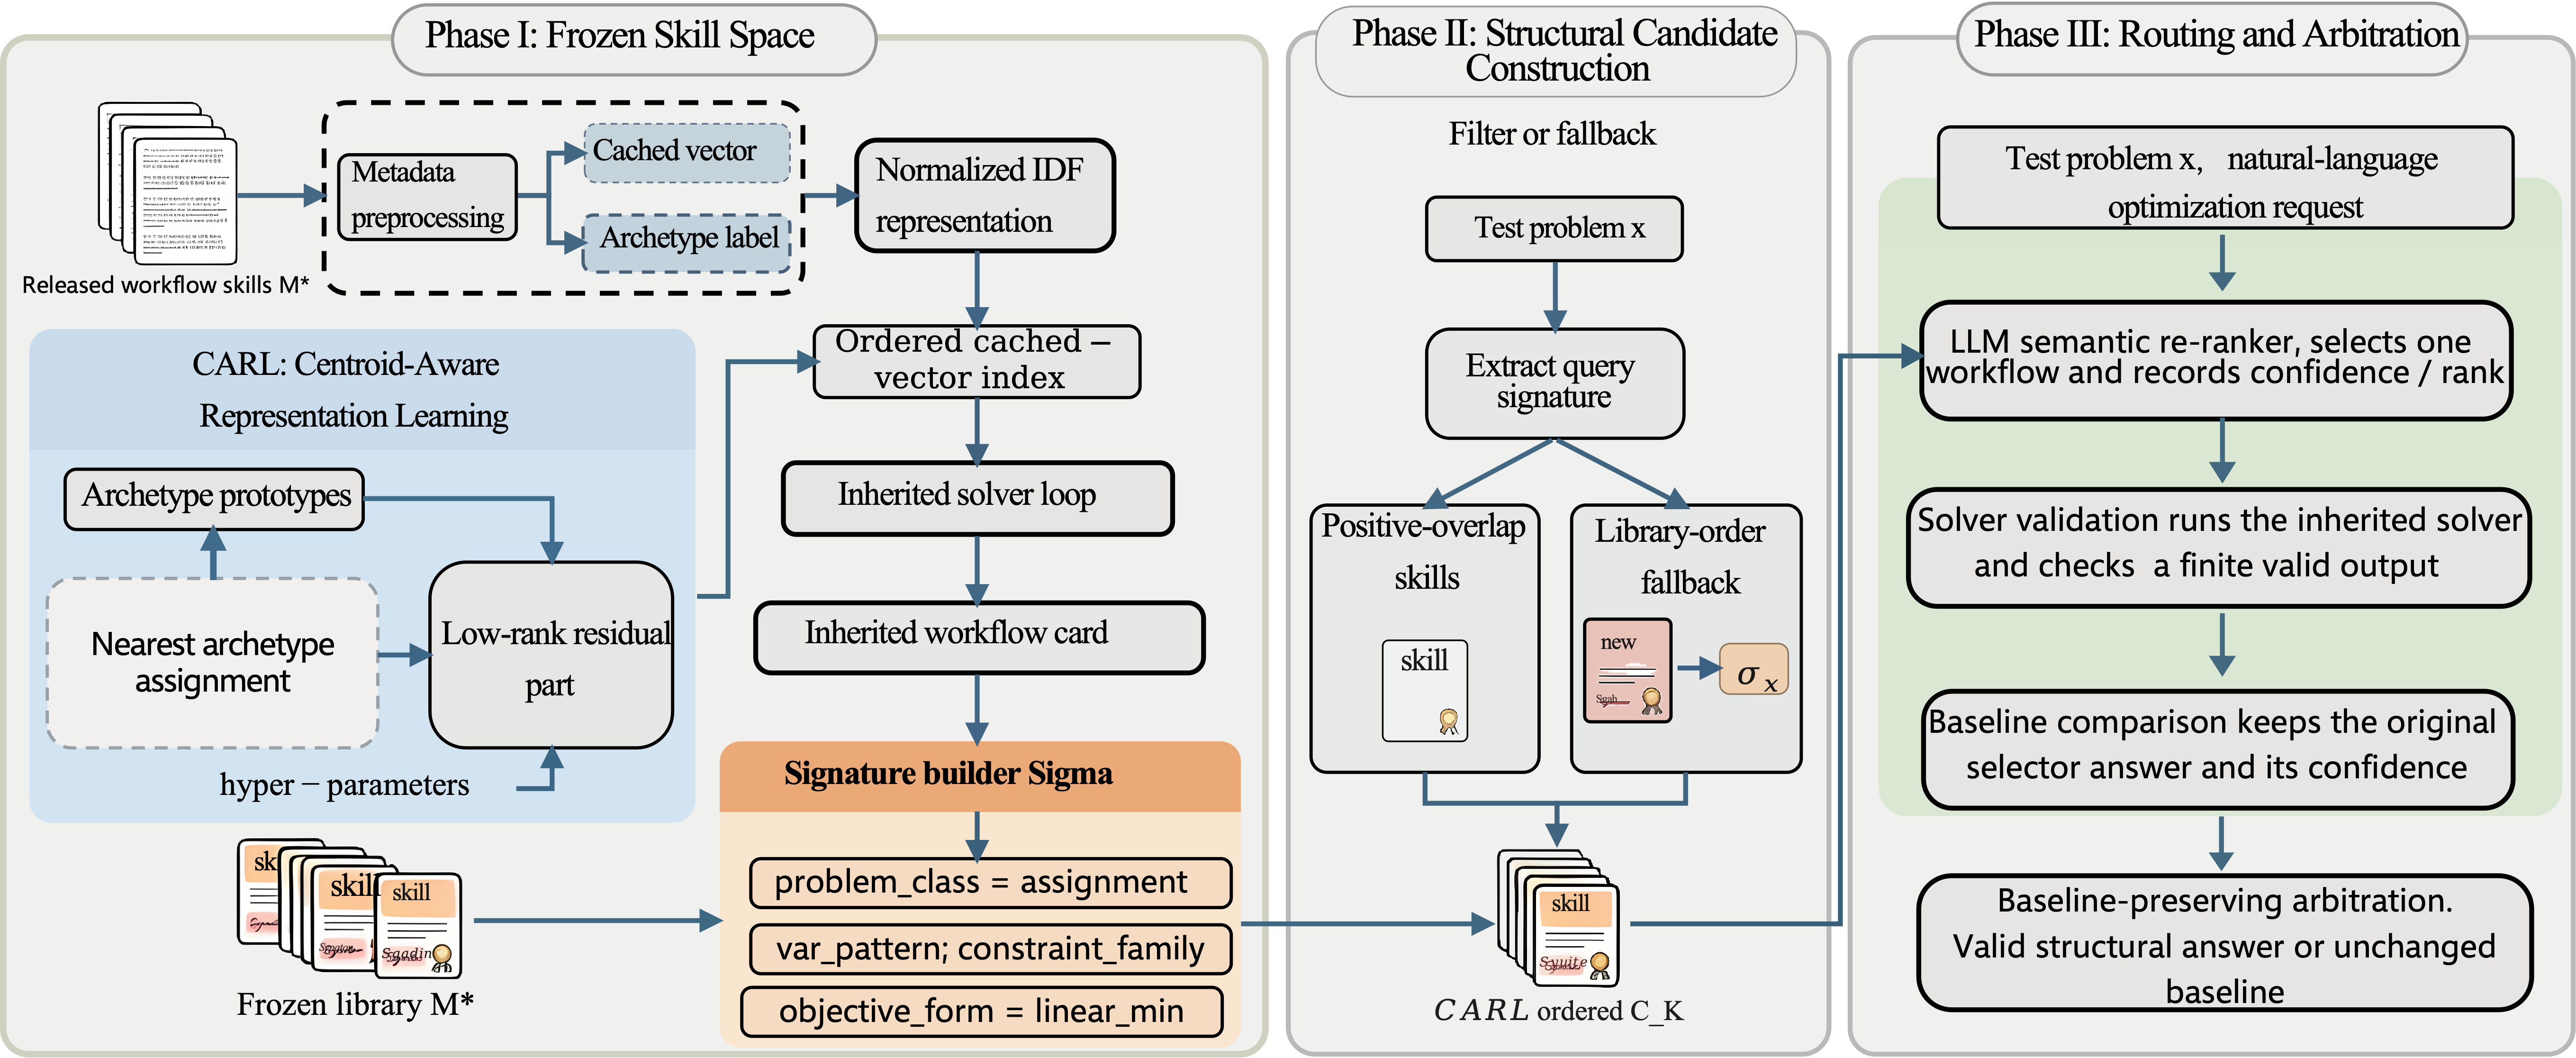
Три этапа: построение представления, проверка структуры и арбитраж ответа. ИсточникМетод, ограничения и следующий шаг
Как устроено. Авторы оставляют замороженную библиотеку OptSkills из 46 навыков и тот же DeepSeek-V4.1-Flash. CARL корректирует cached vectors низкоранговым сдвигом к прототипам; S3R ограничивает semantic reranking восемью структурно подходящими кандидатами. Арбитраж учитывает confidence двух селекторов, поздний ранг выбранного навыка и конечный solver output, после чего принимает новый маршрут либо сохраняет baseline.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. Контролируемые 1 100 запросов, пять benchmark suites, temperature 0, seed 42, до 12 turns и solver timeout 120 s. Micro accuracy 63,36→65,00% (+18 correct; 23 improvements/5 regressions, exact McNemar p=0,0009). Direct CARL+S3R — 61,45%, хуже baseline; retrieval Hit@1 0,607→0,804 не равен end-to-end выигрышу.
Ограничение. Один backbone и один запуск на запрос; 1 100 запросов пяти optimization-бенчмарков, temperature 0 и seed 42. Глобальные пороги арбитража не калиброваны на независимом наборе, поэтому их переносимость не показана. Текущая процедура исполняет обе ветви; уменьшение списка с 46 до 8 не доказывает снижение полной стоимости или latency. Finite solver output проверяет исполнение, а совпадение objective не гарантирует корректность семантики модели. Случай F1 прямо показывает неверный override правильного baseline. Внешние строки таблицы не перезапущены и не составляют причинного сравнения.
Для моей работы. Для библиотеки agent skills полезно логировать совместимость структуры, позицию кандидата, решение селектора и причину override. Это отделяет ошибку поиска от неверной границы применимости навыка; перенос на обычные backend-задачи требует собственной проверки.
Следующий шаг. На сохранённых задачах сравнить baseline, обязательный новый retrieval и селективный override. Добавить атрибуты предусловий и собрать независимую выборку для калибровки порогов.
Haofu Yang, Hongyang Yin, Ran Bi et al. · · Препринт
AOD: агент спрашивает коллегу, когда ответ меняет решение
agents
Параллельные агенты обмениваются не общими сводками, а ответами на конкретный вопрос: что неизвестно, что уже проверено и какое решение зависит от ответа. AOD обучает небольшой шлюз разрешать такие обращения по результату всей команды. На AppWorld и WebShop подход полезнее независимых запусков, но выигрыши зависят от модели, задачи и способа выбора финального ответа.
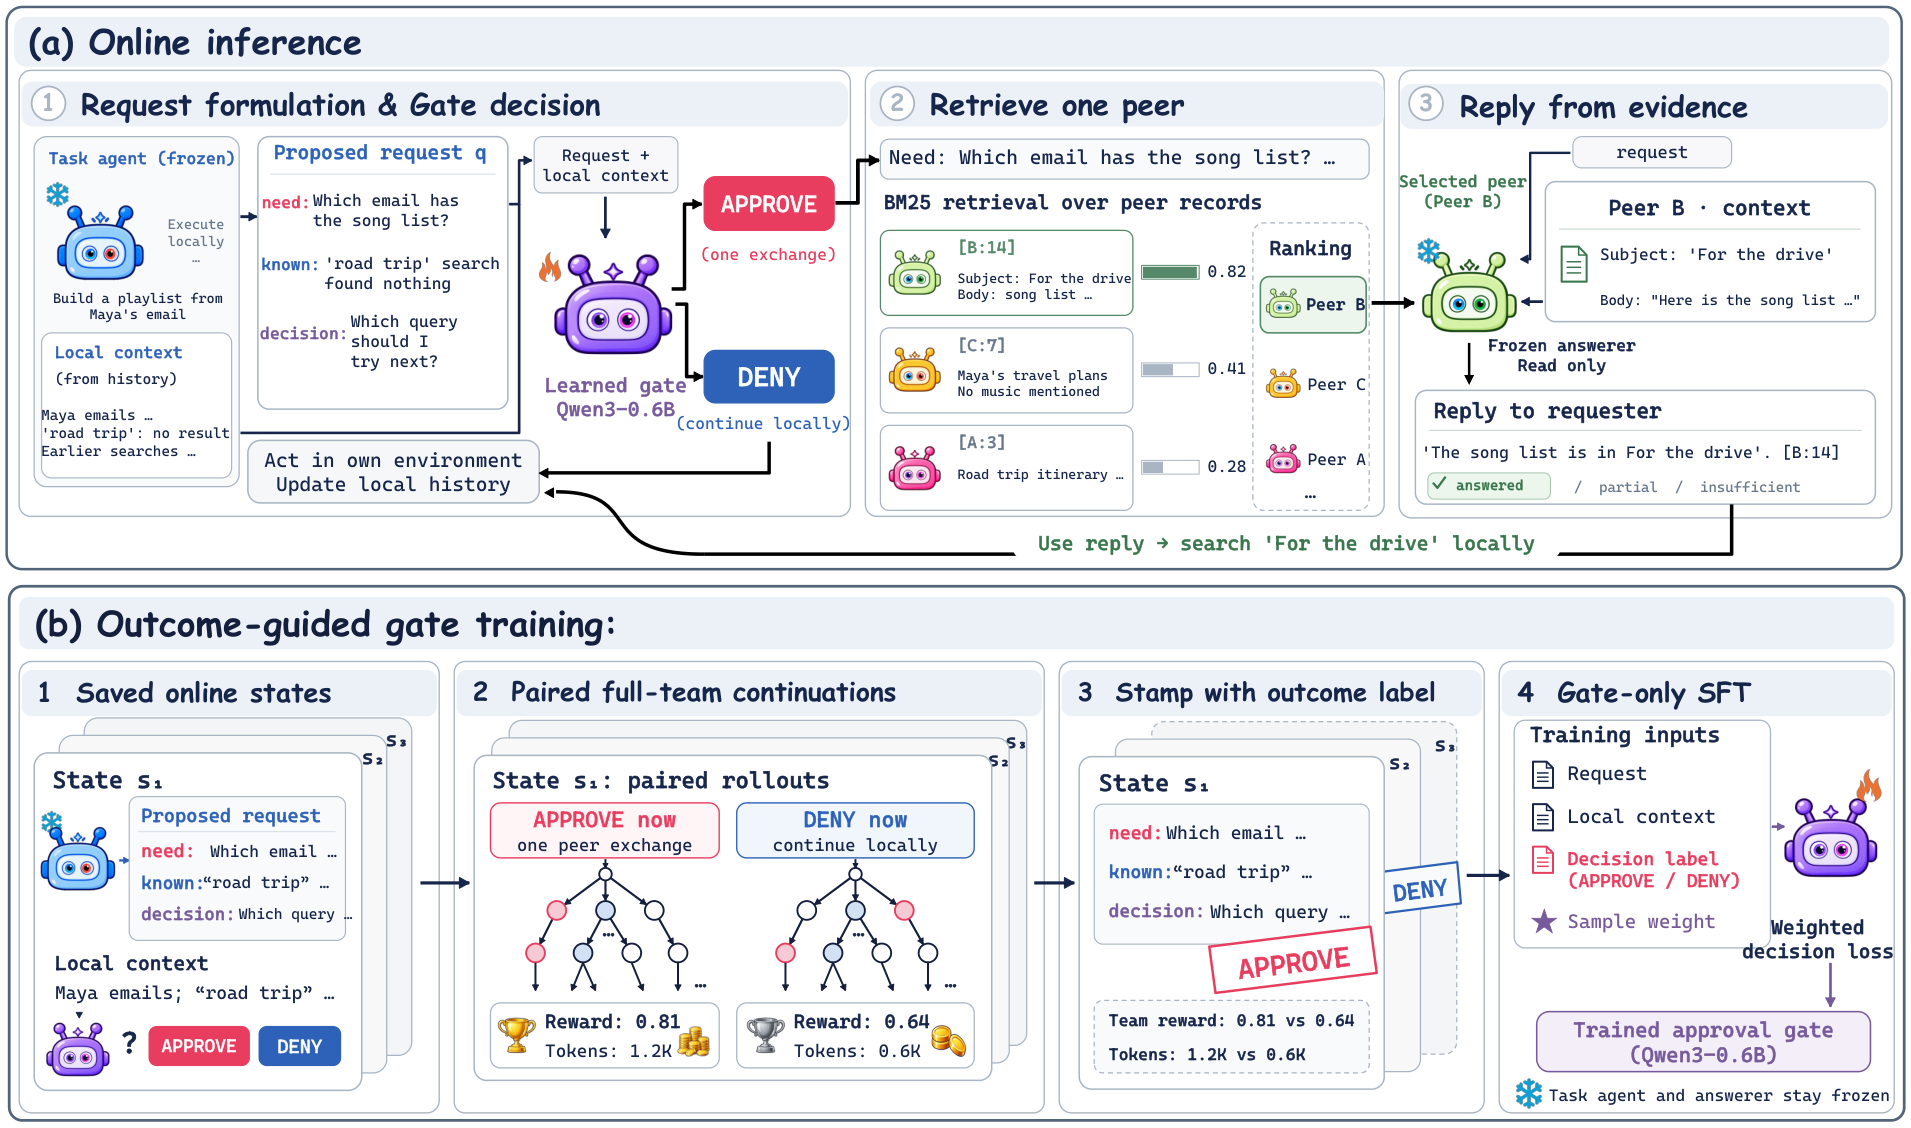
Шлюз разрешает обращение к другому агенту по ожидаемой пользе для командного результата. ИсточникМетод, ограничения и следующий шаг
Как устроено. Три агента решают одну задачу в отдельных средах. По одобренному запросу BM25 выбирает завершённые записи подходящего коллеги; замороженная модель отвечает с цитатами. Шлюз Qwen3-0.6B обучают на парных продолжениях одного состояния: разрешить запрос или запретить. Приоритет получает качество командного результата; стоимость учитывается при равенстве качества. На inference парные продолжения не нужны.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. Таблица 1: Qwen3.5-35B-A3B, три агента, AppWorld TGC 53,89 у Independent и 62,78 у AOD, +8,89 п. п.; 120 задач, среднее трёх seed. Это не общий процент успешности production-агента. На 4B AppWorld AOD уступает LTS по выбранному результату.
Ограничение. 120 AppWorld и 200 WebShop задач, две Qwen-модели, три seed; внешнее supplementary material не входит в сохранённый HTML, а именно туда вынесены splits, failure/selection rules, stability criteria и детали адаптированных baselines. Основной текст прочитан полностью, но воспроизводимость этих деталей не подтверждена; нельзя называть полным прочтением supplementary material или подтверждать его выводы. AOD уступает LTS на 4B AppWorld при confidence-selection. Стоимость storage/retrieval исключена; Agentfugue меняет context compression, так что токены не изолируют эффективность общения.
Для моей работы. Мой вывод: полезная схема интерфейса помощи для backend-команды агентов — вопрос должен называть решение, а ответ сохранять проверяемые свидетельства. Результат исследования не доказывает, что дополнительные агенты окупятся в конкретном production-процессе.
Следующий шаг. Сначала добавить need/known/decision и ссылки на записи в свой протокол помощи; сравнить независимые запуски и запросы по требованию на одинаковом бюджете, учитывая retrieval и выбор финального ответа.
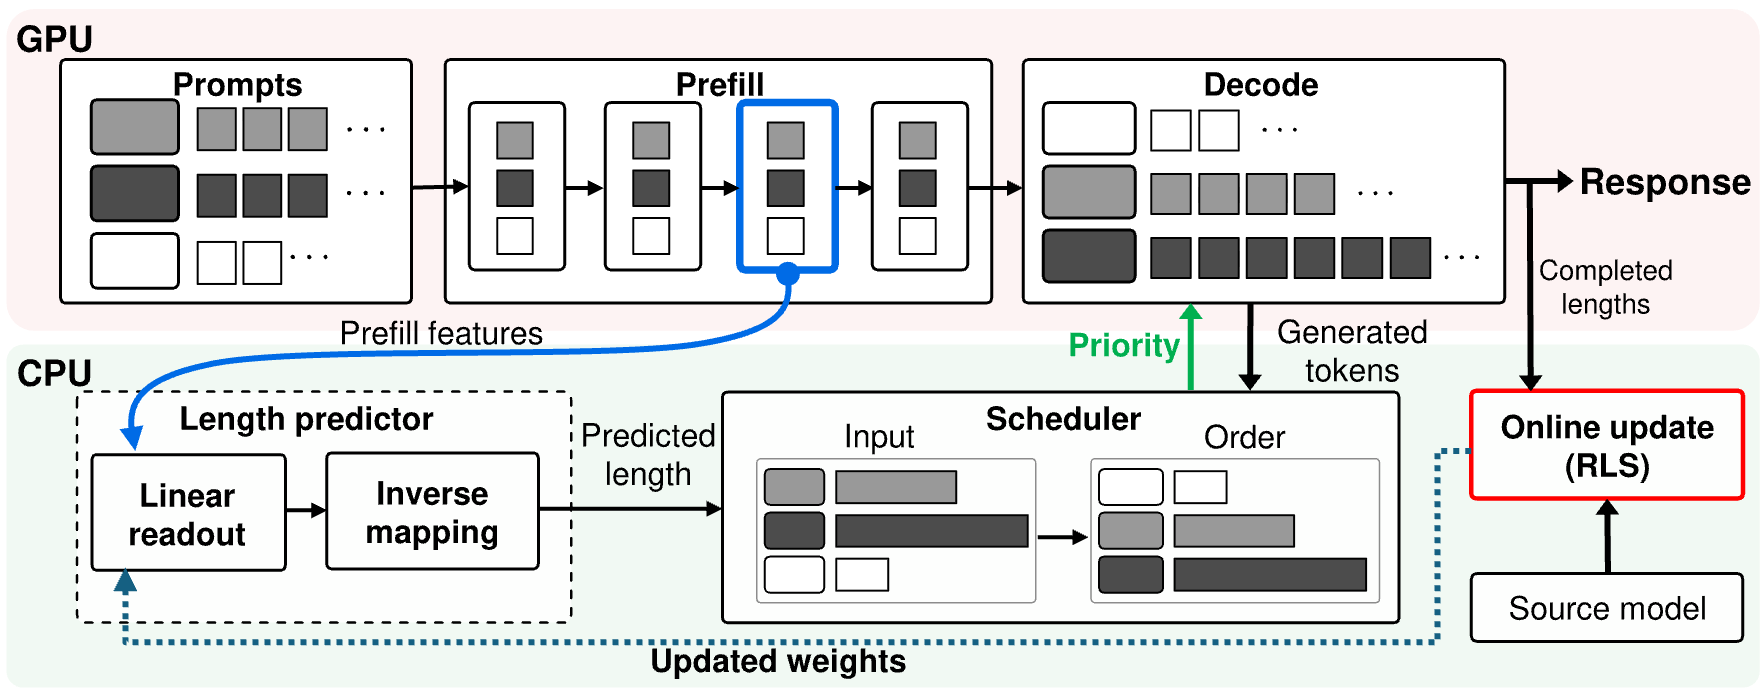
LEAP извлекает прогноз длины из одного hidden state во время prefill и считает линейную модель на CPU, пока GPU продолжает работу. Завершённые запросы помогают обновлять прогноз без backpropagation. Работа показывает, почему точность предсказания нельзя оценивать отдельно от затрат scheduler: более точный динамический прогноз в контролируемом сравнении увеличивал время ответа.
Предсказание длины ответа совмещается с GPU-prefill; сортировка выполняется на CPU. ИсточникМетод, ограничения и следующий шаг
Как устроено. Линейная Ridge-модель учится предсказывать квадратный корень длины ответа по последнему токену позднего слоя. Во время исполнения асинхронный CPU-worker публикует оценку с идентификатором запроса и версией модели. Scheduler вычитает уже сгенерированные токены, защищает долго ожидающие запросы и при отсутствии оценки возвращается к FCFS. Каждые восемь завершений RLS обновляет коэффициенты по фактической длине.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. Таблица 3: ShareGPT, один A800 80 GB PCIe, восемь логических CPU, vLLM 0.8.5.post1, 500 общих запросов при 2,65 request/s. Mean PTL LEAP 63,58 против 75,62 ms/token у LTR: улучшение 15,9%; throughput 1 141,93 против 1 120,88 token/s, +1,9%. PTL — end-to-end latency / output tokens, а не inter-token latency.
Ограничение. Single-GPU eager-mode vLLM; основные serving-точки — одиночные прогоны на общем хосте с capped output 2 048. Снижение mean PTL не равно снижению inter-token latency; длинные запросы ждут дольше, а в domain-transfer simulation predictor runtime исключён и P95 может ухудшаться. В static/dynamic LEAP меняются также training targets, поэтому сравнение не изолирует один refresh hidden states. Prefix cache, chunked prefill и multi-GPU не проверены; RLS не забывает старые наблюдения и не учитывает decoding policy.
Для моей работы. Мой вывод: для собственного inference backend стоит сравнивать весь путь до потребления score scheduler, а не только качество отдельного predictor. Идентификаторы запросов и версионирование результатов полезны и для других асинхронных управляющих моделей.
Следующий шаг. На копии нагрузки измерить среднее и P95/P99 полного ответа с одинаковыми token trajectories; отдельно учесть CPU, передачу features, защиту ожидания и переходы между доменами.
Yanran Wu, Dian Yu, Chongyang Bai et al. · · Препринт
DecisionRank: reranking одним проходом учится на собственных ошибках
agents
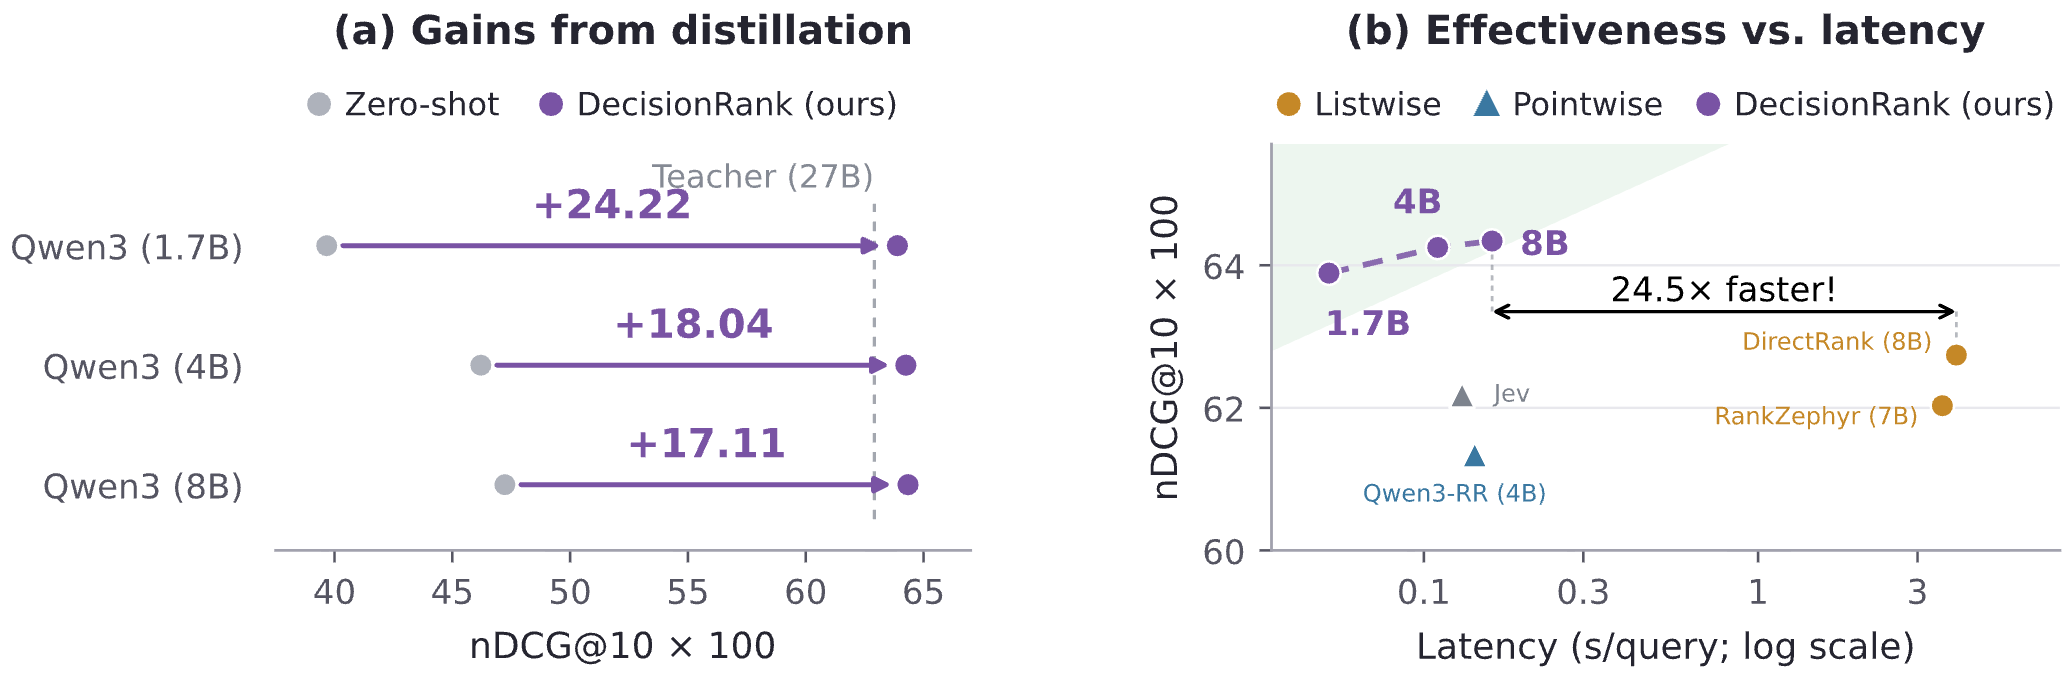
DecisionRank ранжирует до ста документов по logits первого токена, без генерации списка. Обучение соединяет статические rankings учителя с условной обратной связью на текущий порядок ученика. Это позволяет перенести часть качества дорогого generative reranker в быстрый decision model. Выигрыш проверен на нескольких retrieval-наборах, но не означает превосходства в любом домене или при любом бюджете текста.
Качество и задержка ранжирования на одном BM25 top-100; latency не охватывает весь RAG. ИсточникМетод, ограничения и следующий шаг
Как устроено. Ученик сортирует first-token scores и выбирает top-20 кандидатов. Замороженный generative teacher одним teacher-forced проходом оценивает последовательные выборы ученика. Reverse KL выравнивает распределения в пространстве документов, а RankNet сохраняет глобальный порядок из offline rankings. При inference все документы оцениваются одним forward pass; teacher и autoregressive rollout больше не нужны.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. 16 000 training queries; три размера Qwen3-ученика и три семейства учителей. На TREC DL19–23 Qwen3-8B DecisionRank даёт nDCG@10×100 = 64,34 против 62,92 у listwise DirectRank в основной таблице. Заявленные 24,5× на TREC DL и 16,7× на BRIGHT относятся к single-query reranking 100 кандидатов при одинаковом passage limit на B200, не ко всему RAG.
Ограничение. Максимум 100 кандидатов, passages обрезаны до 128/384 токенов. Основная таблица использует исходные document budgets baselines; общие лимиты вынесены в приложение. На R2MED DecisionRank-8B уступает listwise DirectRank (43,55 против 44,50; при shared budget 43,55 против 44,10). Ускорения 24,5×/16,7× относятся к single-query reranking на B200; student timing исключает сортировку и не измеряет весь RAG. Jev сопоставлен по server-reported latency, что не уравнивает оборудование. Seed-проверки даны для TREC DL/BRIGHT, а улучшенная pairwise calibration зависит от qrels и не гарантирует правильность отдельного решения.
Для моей работы. Мой вывод: для latency-sensitive RAG стоит сравнить генерацию rankings с прямой оценкой кандидатов и проверить, совпадает ли training objective с inference readout. Идея item-space alignment позволяет дистиллировать между разными vocabulary и семействами моделей.
Следующий шаг. Проверить собственные qrels, truncation и end-to-end latency, включая retrieval и сортировку. Для обучения сравнить RankNet с совместным objective на фиксированных данных и нескольких seed.
Шесть повторов ложного утверждения затрудняют его обнаружение в RAG
agents
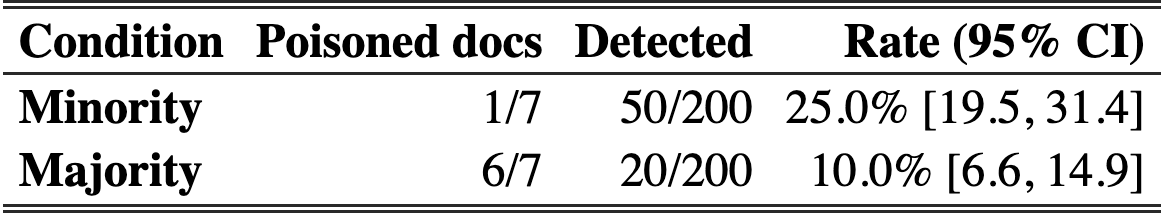
На 200 вопросах SciFact Gemma-3-12b обнаруживала ложный фрагмент в 25 % случаев, когда он соседствовал с шестью корректными документами, и в 10 %, когда ложный исходный документ дополняли пятью его парафразами. Это повод проверять происхождение и зависимость источников: число согласных документов не означает число независимых подтверждений. Причину снижения эксперимент не изолирует.
Таблица авторов: conformity-check пропускает часть атак; один poisoned-документ дополнен пятью парафразами. ИсточникМетод, ограничения и следующий шаг
Как устроено. Авторы сравнили два контекста по семь документов для одних и тех же 200 вопросов, выбранных с seed 38. В первом — один отравленный и шесть здоровых фрагментов; во втором — исходный отравленный фрагмент, пять его парафраз и один здоровый. Модель получала одинаковый запрос на структурированный отчёт об ошибочной информации. Парные исходы сравнили точным тестом Макнемара; интервалы долей вычислили методом Уилсона.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. 25 % = 50/200 против 10 % = 20/200; 15 процентных пунктов. Среди 38 несовпадающих пар 34 потеряли обнаружение и 4 приобрели его. Точный двусторонний тест Макнемара: p = 6,04 × 10⁻⁷. Это явление в фиксированном контексте, а не успешность атаки на retrieval.
Ограничение. Одна Gemma-3-12b и один фиксированный семидокументный контекст; retrieval и конечный ответ не оценивались. Одновременно меняются доля poison, повторения и объём здоровых возражений, поэтому нельзя изолировать конформизм. Бинарные workbook-метки не сопровождены независимой ручной оценкой всех объяснений. В summary следует уточнить: исходный poison плюс пять парафраз, а не шесть парафраз.
Для моей работы. Для backend-инженера это основание добавить дедупликацию и отслеживание происхождения в RAG-eval. Это мой вывод о применении; работа не проверяла такой способ защиты и не измеряла качество конечного ответа.
Следующий шаг. В своём наборе отдельно варьировать повторения одного источника и число независимых источников при постоянном числе корректных документов; оценивать и обнаружение лжи, и конечный ответ.
Архитектурный gate должен отличать разрешённую зависимость от ненаблюдаемой
agents
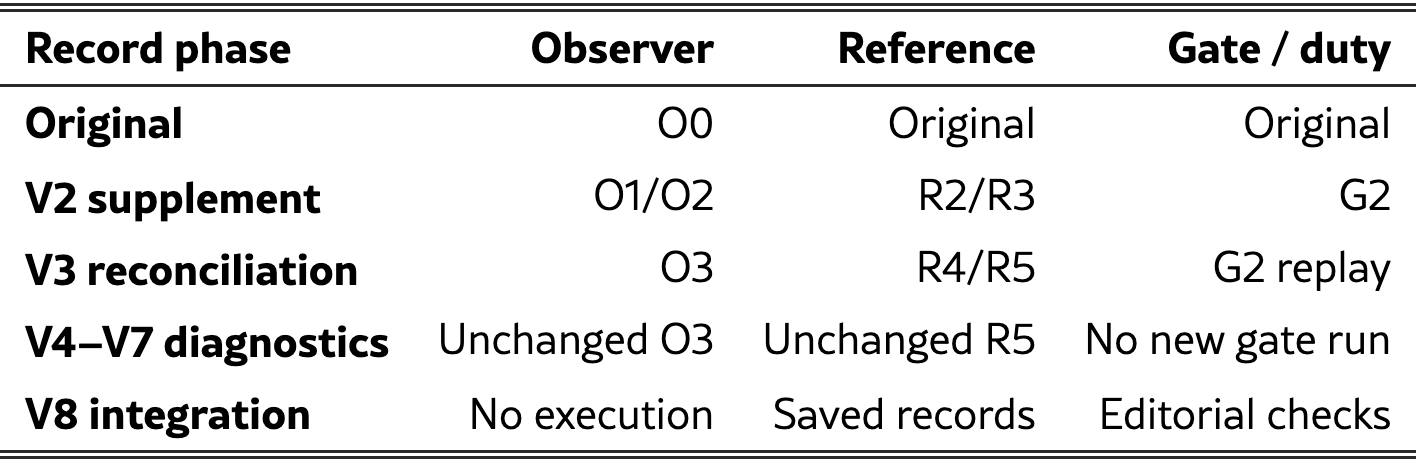
Исследование разделяет четыре обязанности архитектурного gate: полноту наблюдения, идентичность запрещённой связи, унаследованный долг и право обновить baseline. На 240 файлах полное согласие с программным эталоном достигнуто только в совместно проверяемом подмножестве из 166 файлов. Оставшиеся 74 сохраняют UNKNOWN. Практический вывод — пустой список нарушений нельзя читать как гарантию отсутствия запрещённых зависимостей.
Порядок фиксации запусков и последующих проверок: дополнительные тесты не подменяют исходный результат. ИсточникМетод, ограничения и следующий шаг
Как устроено. На четырёх зафиксированных TypeScript/JavaScript-репозиториях автор сравнил наблюдатель зависимостей с отдельным Babel/TypeScript-reference. В конструируемых сценариях проверяли замену одной запрещённой связи другой и возврат ранее удалённого долга. Дополнительная обёртка связывала evidence с текущими source, scope, policy и epoch baseline; функциональные проверки и timing отдельно ограничили двумя package scopes. Историю провалов и исправлений сохранили.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. 166/240 = 69,17 % совместной квалификации, с точным reference-relative совпадением; 74 UNKNOWN. В 480 построенных сценариях и candidate shrinking, и dependency-cruiser совпали с 480 ожидаемыми исходами; static identity — 420, count-only — 360. Преимущество над зрелым shrink-only инструментом не показано. Полные деревья не прошли все 120 исходных timing-попыток.
Ограничение. Артефакты private, независимое воспроизведение не установлено; reference программный и исправлен после просмотра исходов, часть resolver-предположений общая. 480 сценариев переиспользуют 60 anchors, успешные bounded проверки — только два package scope и два anchors; все 120 исходных full-tree timing-попыток unqualified. Нет естественных траекторий coding-агентов, оценки продуктивности или общего fail-closed доказательства. Защита требует trusted runner/policy/baseline и не обеспечивает distributed durability.
Для моей работы. Для CI вокруг coding-агентов полезно разделить REJECT и UNKNOWN, хранить идентичности долга и проверять актуальность source/scope/policy перед принятием результата. Это инженерная интерпретация ограниченного эксперимента, а не гарантия корректности конкретного инструмента.
Следующий шаг. Проверить свой dependency gate на два случая: компенсация числа нарушений новой связью и повторное введение уже удалённой связи. Отдельно убедиться, что пропущенный файл или устаревший scan не дают PASS.
Wenbo Ye, Yongxi Zhou, Junwei Yao, Jiahui Ge · · Препринт
Память о неудачном ремонте: урок пока не лучше исходного transcript
agents
В исследовании реальных Python-дефектов повторный запуск с памятью имел более высокий точечный результат, чем простой retry, но основные различия не выдержали поправку на множественные сравнения. Написанный моделью урок не превзошёл transcript, из которого получен, и потребовал лишний вызов. Полный набор тестов дополнительно ослабил часть выигрыша: видимые bug-revealing tests могут ранжировать стратегии иначе. Этот вывод относится к видимым bug-revealing тестам; post-hoc полный набор тестов даёт REFLECT небольшое преимущество по точечной оценке.
Метод, ограничения и следующий шаг
Как устроено. Для 75 BugsInPy-задач запускали шесть независимых первых попыток gpt-5.4-mini; 181 неудачу повторили с NONE, HISTORY, REFLECT, SIGNAL и BOTH из исходного workspace. HISTORY и REFLECT строились по одному усечённому record, что изолирует шаг суммаризации. Сравнения парные, с task-cluster bootstrap и Holm correction. Затем добавили gpt-5.4 и notice-only control; full-suite анализ помечен post hoc.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. M1: plain retry 29,8 % на 181 failures; HISTORY +9,4 п. п., REFLECT +7,2, SIGNAL +5,5, BOTH +9,9, ни одно primary различие не значимо после Holm. REFLECT−HISTORY = −1,7 п. п., 95 % CI [−8,7; +4,9]. Full-suite оценки HISTORY +5,0, REFLECT +7,2; все интервалы включают ноль. M2: 85 failures, REFLECT−HISTORY −3,5 [−14,1; +8,2].
Ограничение. Основные различия M1 не значимы после Holm; это не доказательство отсутствия эффекта или эквивалентности. REFLECT−HISTORY допускает от−8,7 до+4,9 п. п. в M1 и от−14,1 до+8,2 в M2. На post hoc full-suite endpoint REFLECT немного впереди HISTORY по точечной оценке, поэтому формулировка «урок не лучше transcript» применима только как отсутствие показанного преимущества на bug-revealing tests. Ограничены одна семья моделей, короткий harness, pure-Python задачи, концентрация black; есть interruptions и interim look, все p-values nominal.
Для моей работы. При выборе памяти для repair-агента нельзя считать reflection обязательным улучшением: сравнивать нужно с plain retry и transcript при одинаковом бюджете. Для backend/Coding harness особенно полезен раздельный учёт прохода bug tests, полного suite и стоимости всей попытки. Это мой вывод о применении результатов.
Следующий шаг. На своих дефектах сравнить plain retry, transcript и lesson; сбрасывать workspace, сохранять одинаковые лимиты и проверять широкий regression suite. Не внедрять дополнительный reflection-call только по росту точечной метрики.
Ira Ceka, Arnav Garg, Ryan Lutz et al. · · Препринт
MetaVul: улучшать проверку уязвимостей через harness, сохраняя отдельный тестовый набор
agents
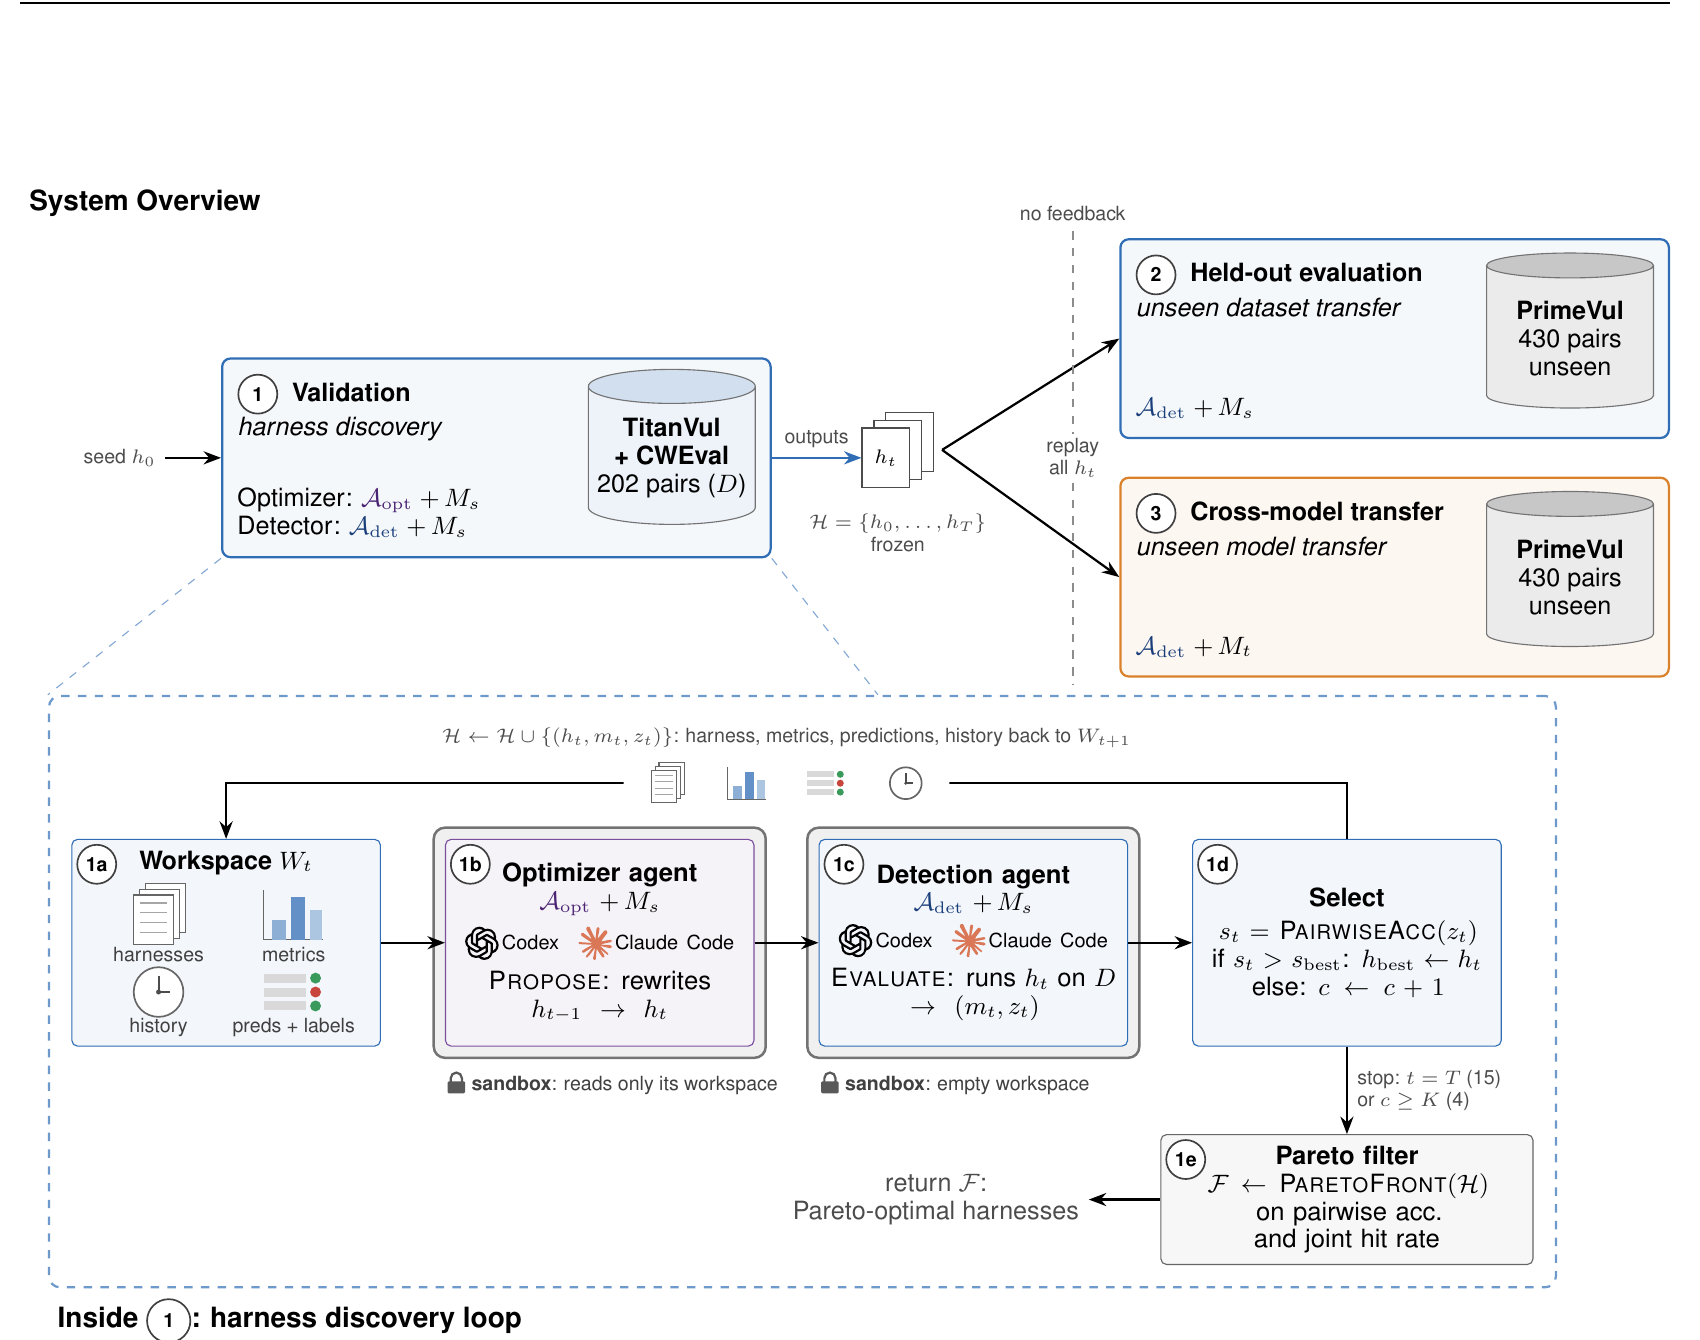
MetaVul ищет не новую модель, а обвязку детектора уязвимостей: агент меняет Python-harness по обратной связи, затем авторы замораживают варианты и проверяют их на других данных и моделях. Полезная часть для инженера — разделение поиска, независимого исполнения и выбора по нескольким метрикам: улучшение различения уязвимого кода и патча может сопровождаться потерей recall.
MetaVul разделяет поиск harness на validation и проверку переноса на закрытом PrimeVul. ИсточникМетод, ограничения и следующий шаг
Как устроено. Оптимизатор получает историю harness, метрики и размеченные предсказания на 202 парах TitanVul/CWEval. Отдельный детектор видит только одну функцию и обвязку; PrimeVul не доступен поиску. После максимум 15 итераций сохраняется Pareto-фронт по pairwise accuracy и совместному попаданию в CWE и строки. Замороженные harness затем проверяются на 430 очищенных от пересечений парах и переносе между моделями.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. Валидация: 202 пары, 161 C и 41 C++; тест: 430 пар PrimeVul после удаления 5 пересечений. Прирост 5,6–25,8 п. п. на тесте относится к выбранным вариантам Pareto-фронта и конкретным моделям, не ко всем запускам. Сравнение GPT-4o: 103/435 против 74/435 у seed и 81/435 у VulTrial; после удаления пересечений 100/430 против 71/430. Recall при этом падает.
Ограничение. Только отдельные C/C++ функции без контекста репозитория; число повторов, итераций и пар моделей ограничено бюджетом. Рост pairwise accuracy сопровождается падением recall, локализация улучшается лишь у 10 из 40 harness. GPT-4o сравнение использует результаты других работ и лучший из ограниченного набора перенесённых вариантов, а не независимый повтор всех baseline. Изменённые патчем строки — proxy истины локализации; contamination публичных наборов полностью не исключена.
Для моей работы. Мой вывод: при автоматизации security review стоит разделить настройку harness и закрытую оценку, а улучшение precision проверять вместе с пропущенными уязвимостями. Показатель pairwise accuracy полезен для проверки, замечает ли детектор собственно исправление.
Следующий шаг. Собрать небольшой закрытый набор уязвимая функция/патч из своего домена и сравнить исходный и изменённый harness по обеим ошибкам, не давая оптимизатору доступ к контрольным парам.
CodeSpecWeave: проверять совместное выполнение требований, а не длину списка
agents
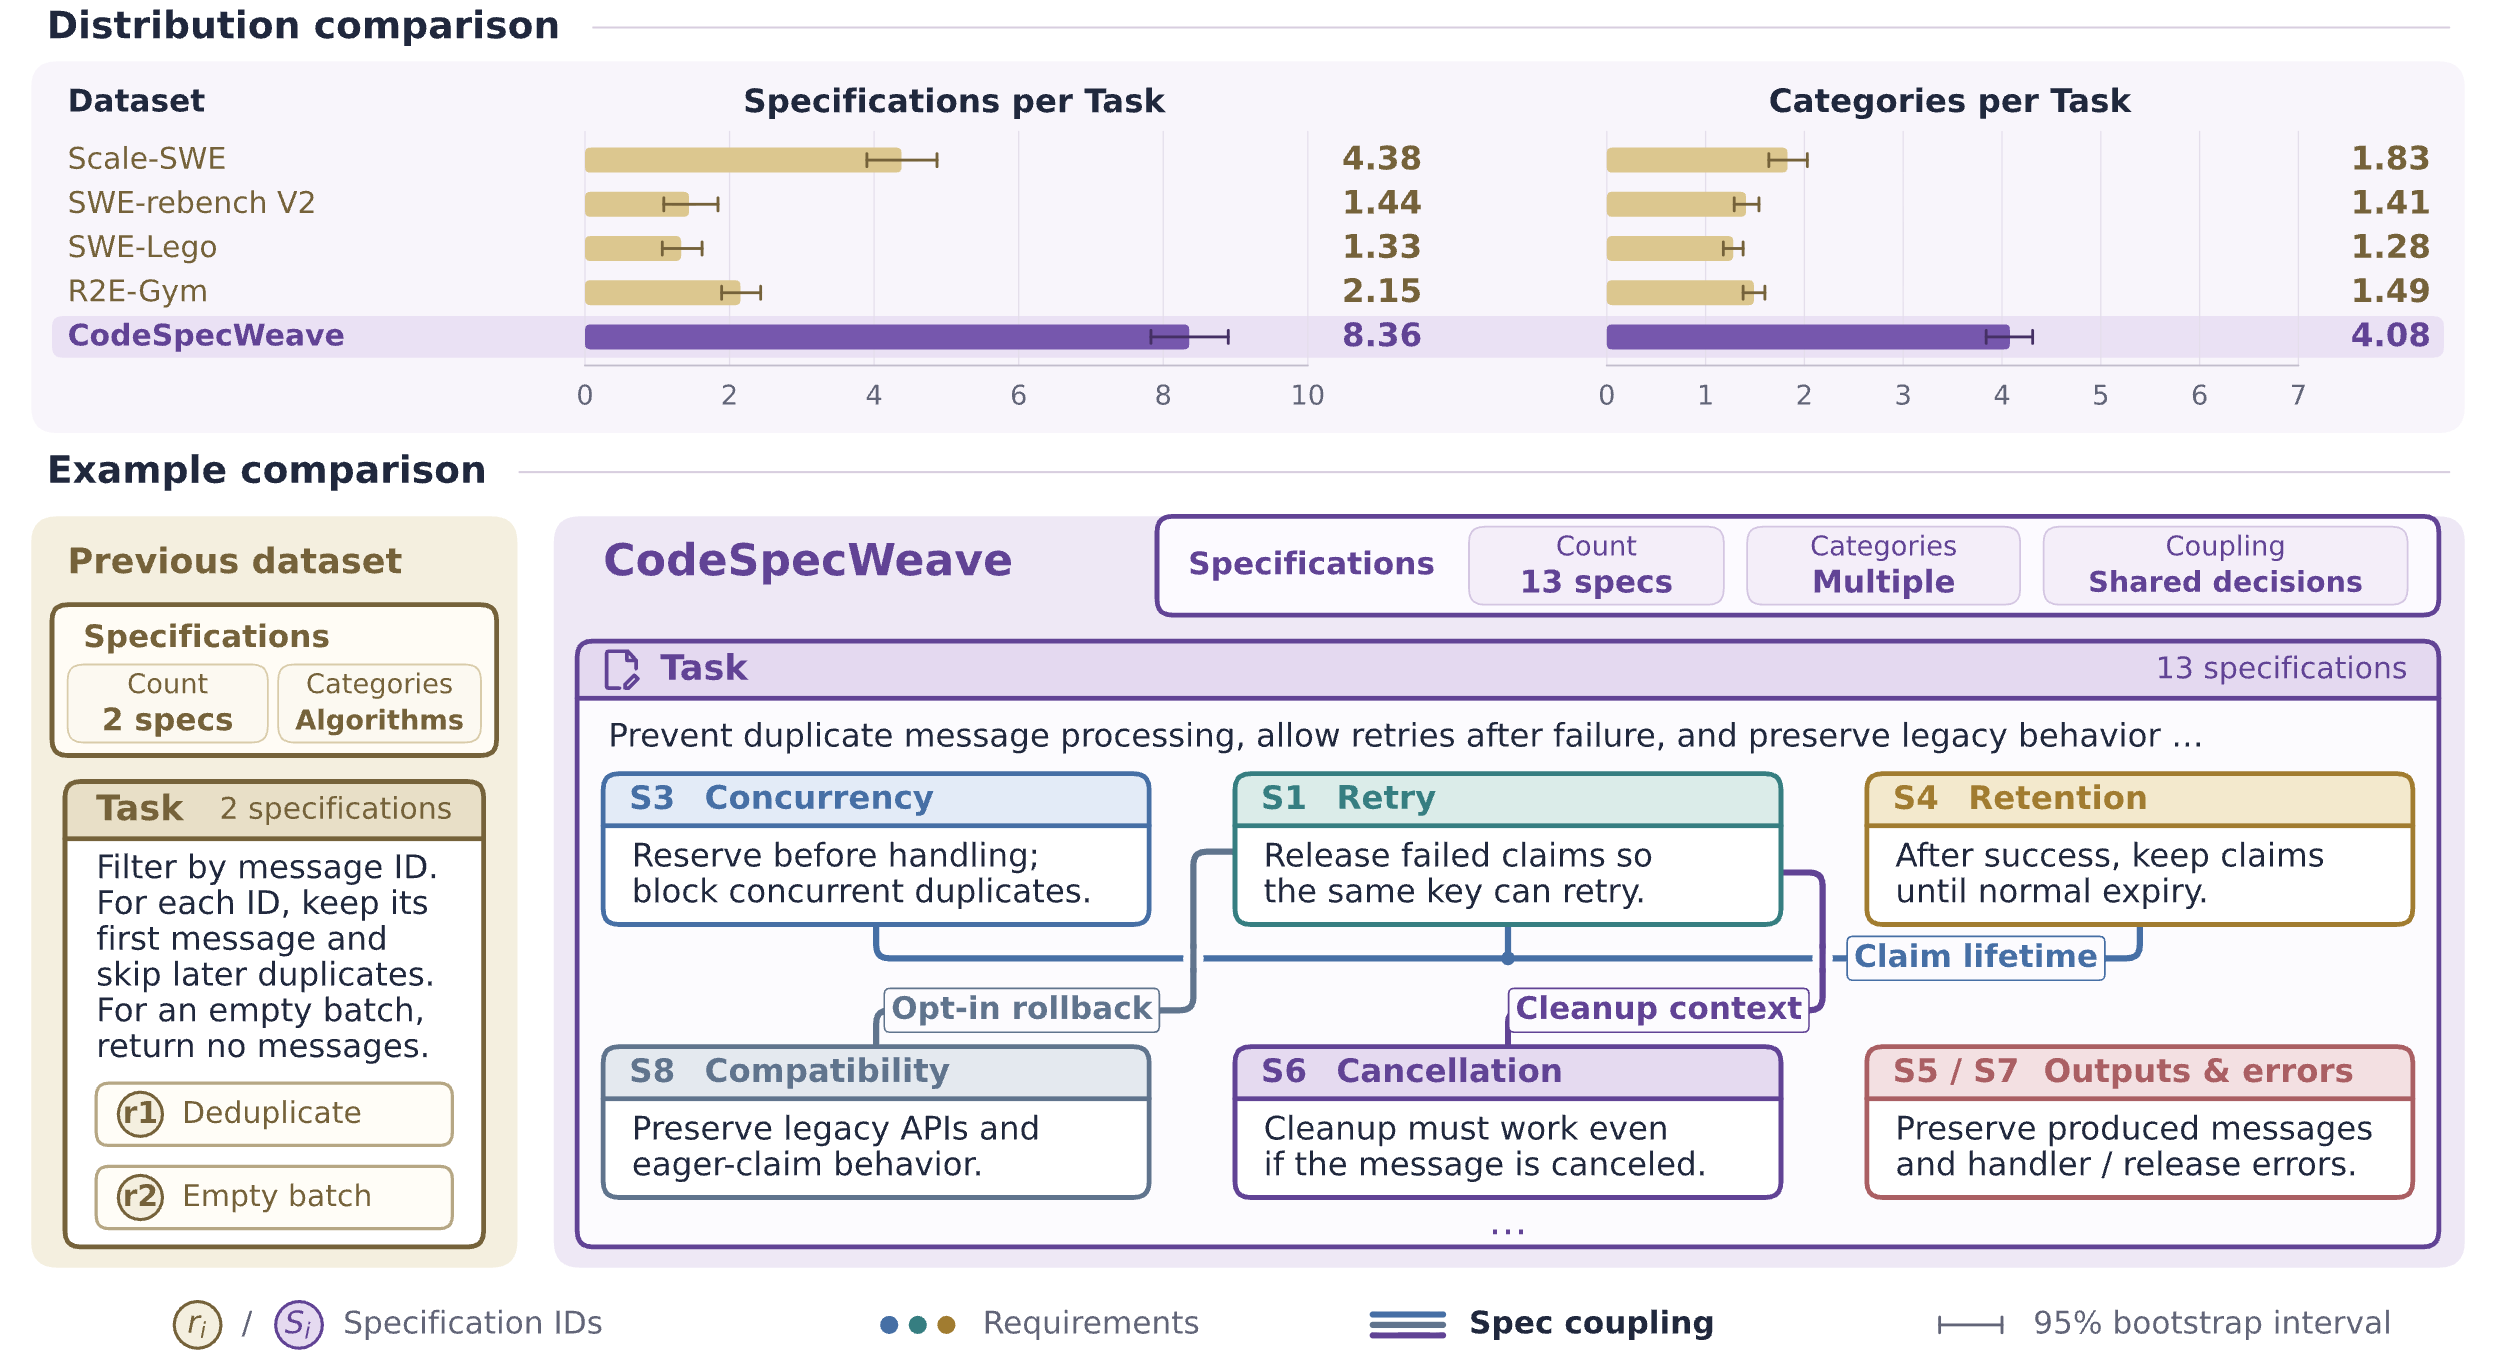
CodeSpecWeave строит задачи, в которых совместимость, состояние и обработка ошибок ограничивают друг друга. Синтез требований и тестов дополняет проверка реальных траекторий решений: тесты могут пропускать неверный патч или отвергать допустимый. Работа полезна для проектирования coding-evals, потому что показывает, почему наличие проверки каждого пункта по отдельности ещё не проверяет их взаимодействие.
CodeSpecWeave связывает спецификацию требований и категории поведения, а не только текстовый ответ. ИсточникМетод, ограничения и следующий шаг
Как устроено. Из разработческих обсуждений и изменений извлекаются образцы требований. Агент синтезирует связанные спецификации и исполняемые тесты в репозитории; другие модели решают задачу, а review-агент проверяет соответствие запросов, траекторий, патчей и тестов. Авторы получили 4 670 тренировочных задач в 2 865 репозиториях и вручную проверенный benchmark из 100 задач с 1 044 спецификациями. Два MiMo-backbone дополнительно обучены с GRPO.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. Benchmark: 100 задач, по три попытки, контекст 512K, temperature 1,0. На DeepSWE-v1.1 MiMo-V2.5 растёт с 12,39 до 25,30%, Flash-SFT — с 54,42 до 62,98%. Это RL-сравнение определённых backbone и датасетов; среднее по четырём benchmark невзвешенное. В пилотных 3 067 кандидатах automated review нашёл проблемы согласования у 73,9%, это не частота ошибок финального benchmark.
Ограничение. Синтетические задачи и ручная проверка авторами 100 benchmark-задач не дают независимой гарантии полноты verifier. Для сравнения моделей использованы разные agent harness, а RL проверен на двух родственных MiMo-backbone; бюджет evaluation — три samples на задачу и 512K контекста. Увеличение reasoning/файлов/строк не доказывает безопасность широкого рефакторинга: в первых 40 turns доля повторных edit–test loops у Flash-SFT даже снижается с 47,7 до45,7%. Заявлять универсальное преимущество на всех SWE-бенчмарках нельзя: MiMo Coding выше на отдельных столбцах.
Для моей работы. Мой вывод: в backend-evals следует включать совместные сценарии rollback, порядка вызовов и обратной совместимости. Они ближе к рискам реального изменения API, чем отдельные независимые unit-проверки.
Следующий шаг. Взять один свой сценарий с транзакцией и совместимостью API; добавить тест, где удовлетворение нового правила может нарушить сохранность прежнего состояния. Проверить тесты и на альтернативном корректном решении.
Распознать вредную инструкцию в памяти ещё не значит написать безопасный код
agents
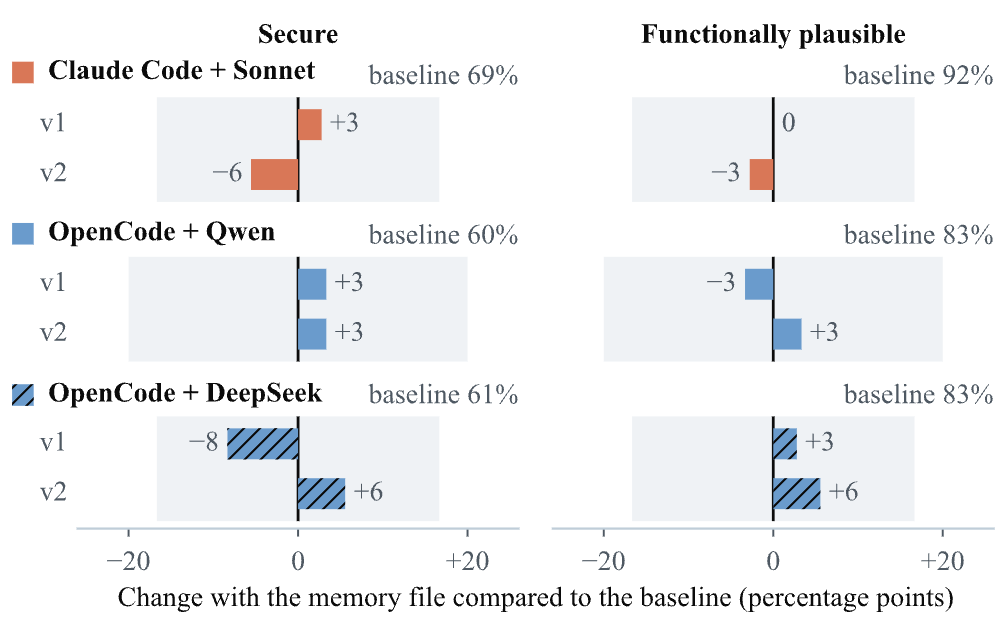
Авторы поместили вредные CLAUDE.md и AGENTS.md в C/C++-репозитории и проверили код трёх agent-конфигураций на функциональность и безопасность. Сдвиги secure-completions оказались небольшими и разнонаправленными; надёжного причинного эффекта эта выборка не устанавливает. Зато объяснение агента расходится с результатом тестов: упоминание атаки не гарантирует безопасный патч, а молчание не означает отсутствия влияния.
Изменение security и functionality относительно baseline мало и разнонаправленно; все сдвиги внутри диапазона случайности. ИсточникМетод, ограничения и следующий шаг
Как устроено. На 36 задачах SecRepoBench сравнили baseline без memory-файла и две версии вредных инженерных рекомендаций. Claude Code/Sonnet 5.5 и OpenCode с Qwen 3.8 27B или DeepSeek V4.1 Flash запускали по одному разу на режим. Security определяли sanitizer/OSS-Fuzz PoC, функциональность — тестами, проходящими на reference-fix; упоминания файла в reasoning и final message проверяли вручную.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. Сдвиг security от −8 до +6 п. п., без согласованного направления. Среди 204 пар 30 расходятся по security: по 15 в каждую сторону; одна попытка не отделяет воздействие от случайности.
Ограничение. 36 быстрых C/C++ задач из SecRepoBench, 12 CWE и 15 репозиториев; по одному completion на task/mode, с повтором только после сбоя сессии. Шесть Qwen-задач исключены из всех режимов из-за неполных результатов. PoC проверяет одну целевую слабость, а функциональные тесты не доказывают безопасность. Claude thinking summaries и OpenCode raw reasoning не сопоставимы напрямую; данные только по запросу. Нулевой либо разнонаправленный эффект здесь не доказывает безвредность attack surface.
Для моей работы. Ревьюировать изменения project-memory как код и оценивать безопасность патча отдельными тестами. Это моя рекомендация по процессу; работа не доказывает эффективность конкретного фильтра memory-файлов.
Следующий шаг. Добавить видимый diff инструкций к review agent-патча; проверить, что security-тесты запускаются независимо от итогового объяснения агента.
Wesley K. G. Assunção, Ramesh Periyathambi · · Препринт
Контекст для code-agent должен учитывать конкретный deployment
agents
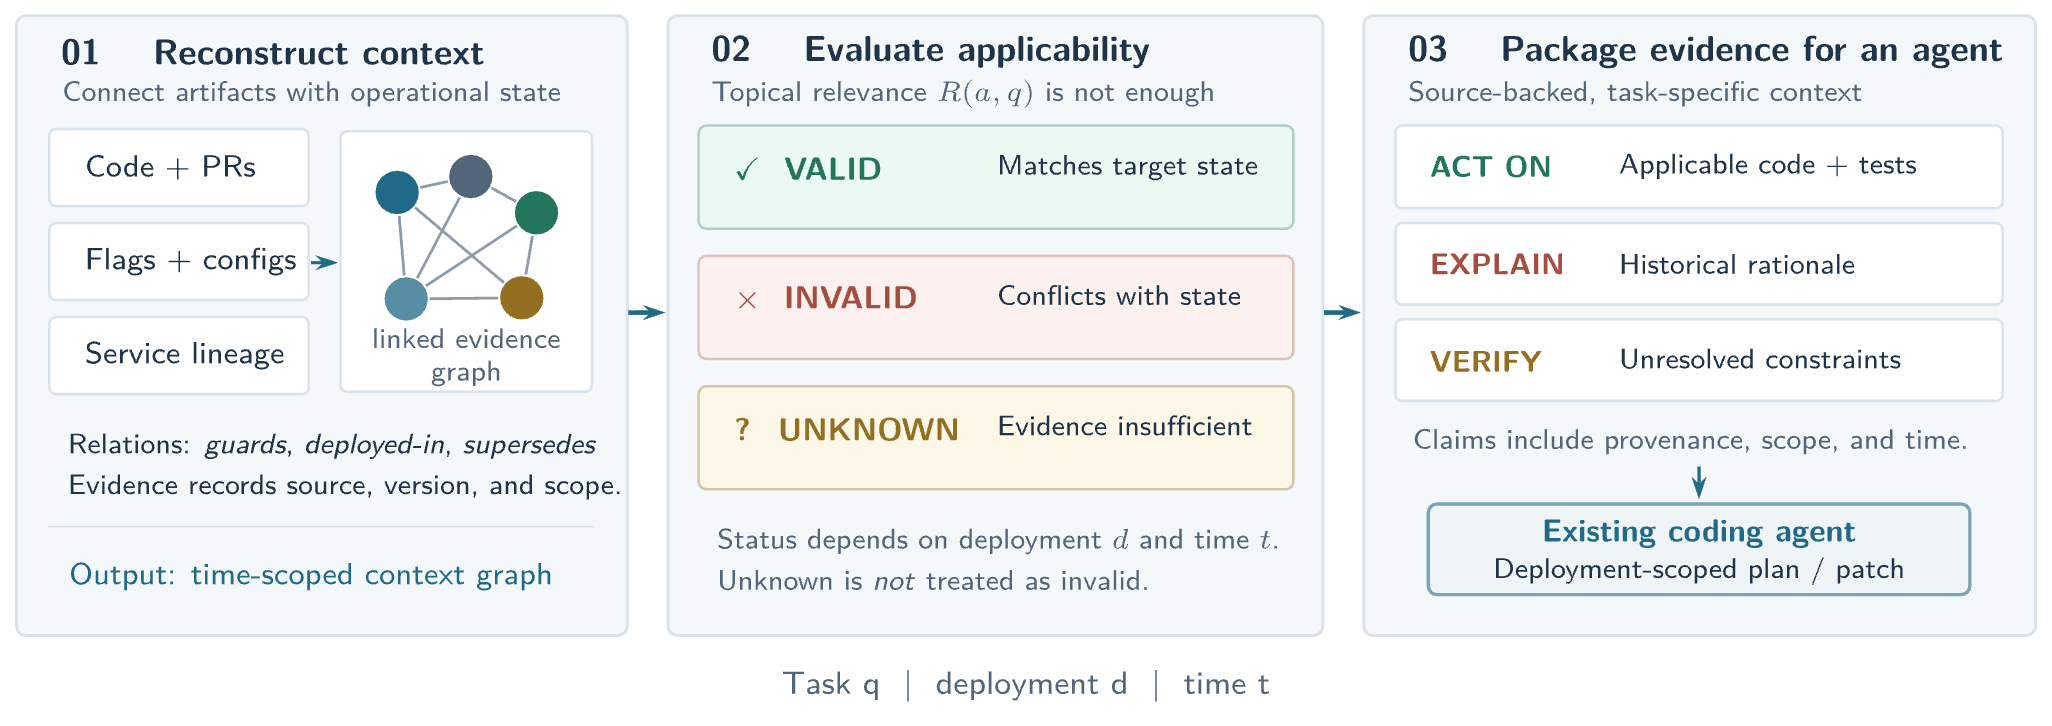
CASE отделяет релевантность найденного кода от его применимости к региону, флагам и моменту времени. Старая REST-реализация может оставаться правильной после регионального rollback, пока новая GraphQL-ветка не активна. Прототип показывает, как упаковать valid, invalid и unknown evidence для агента; идеальные результаты синтетического replay не доказывают улучшения реальных патчей.
CASE сохраняет неизвестную применимость отдельно от подтверждённых и недействительных свидетельств. ИсточникМетод, ограничения и следующий шаг
Как устроено. Прототип связывает артефакты, flags, deployments и миграции в versioned graph; каждому предписанию добавляет scope, timestamp и provenance. В fixture merchant-trust использовали 15 артефактов, три deployment и шесть задач; BM25 формировал общий top-eight pool. Четыре стратегии и две абляции сравнили при близком бюджете 1 500 токенов, измеряя применимость контекста, а не код агента.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. В шести синтетических задачах semantic-only показывает 16 несовместимых и 5 неизвестных артефактов как actionable. CASE исключает их; без flags recall падает до 0,13. Метрики следуют авторским reference-rules.
Ограничение. Синтетический пилот: 15 артефактов, три deployment и шесть задач; связи и условия применимости заданы вручную. Reference labels следуют тем же правилам, что CASE, поэтому precision/recall 1,00 не являются независимой проверкой и не доказывают generalization. Измерен отбор контекста, а не корректность патчей. Абляция lineage не меняет результат; стоимость поддержки evidence не измерена.
Для моей работы. Для backend с feature flags полезно передавать агенту целевой регион, cohort и rollout-state, сохраняя unknown вместо предположения. Это инженерная интерпретация идеи; гарантии корректного изменения сервисов нет.
Следующий шаг. На одной миграции собрать два context-package для разных deployment и вручную проверить, что историческое объяснение не стало инструкцией использовать неактивный путь.
Saiful Khan, Yiwen Xing, Joyraj Chakraborty, Afrah Farea, Philip Beaucamp, Samuel Jackson, Min Chen · · Препринт
Индексировать производные датасеты вместе с их происхождением
agents
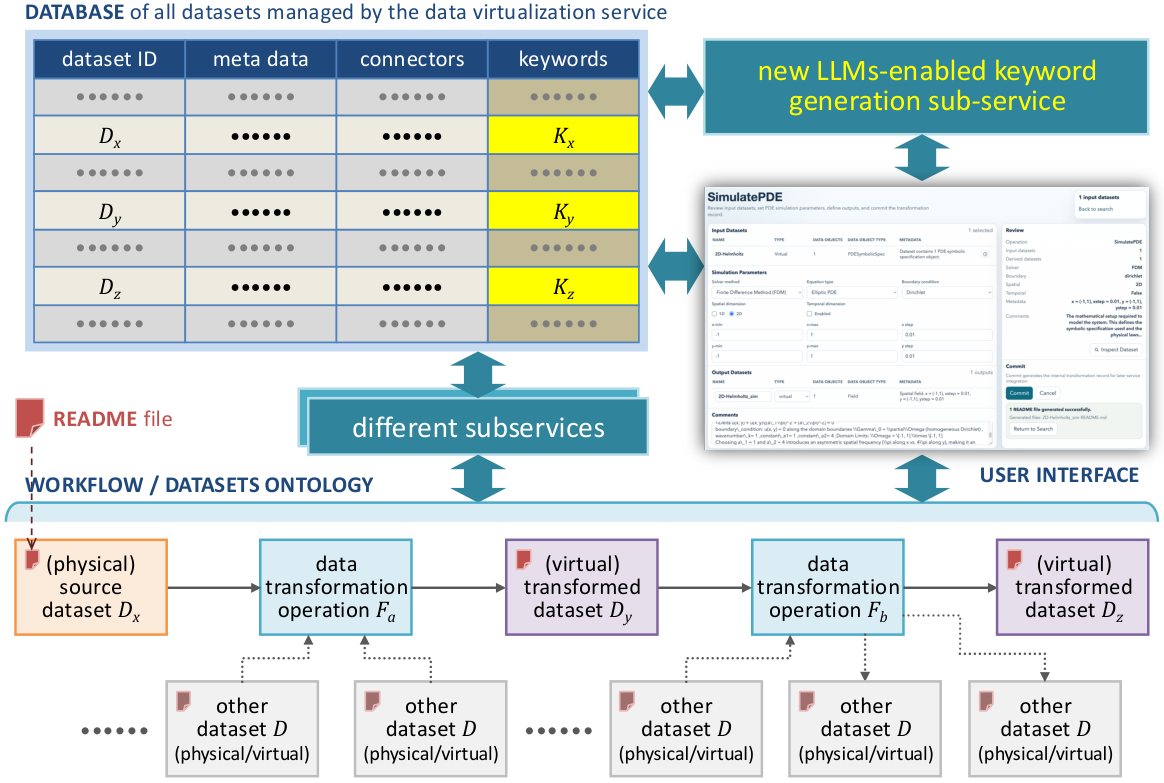
Авторы встраивают генерацию поисковых тегов в сервис виртуализации данных: новый датасет получает ключевые слова из README, описания преобразования и метаданных родителей. Полезна связь асинхронного индексирования с provenance graph. Эксперимент показывает зависимость качества от контекста и модели, но не измеряет производительность эксплуатации на потоке: заявленный high-volume сценарий проверен на небольшом наборе.
Архитектура сервиса генерации и фильтрации ключевых слов. ИсточникМетод, ограничения и следующий шаг
Как устроено. При регистрации датасета KGS проходит граф происхождения в топологическом порядке, собирает один из пяти вариантов контекста и запрашивает JSON-массив из 6–10 тегов у локальной модели. Ответ парсится, проверяется и сохраняется как свойство узла; vector database индексирует metadata и keywords. Три генератора сравнивают с YAKE, TF-IDF и KeyBERT при двух embedding-оценщиках.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. 38 датасетов, 5 workflows, 3 генератора (Gemma3 27B, Llama3.2 3B, Mistral 7B), 2 embedders. По таблице III Gemma3 semantic F1 0,749 Qwen/0,532 MiniLM; chance 0,633/0,307, rescaled 0,30/0,29. Авторская фраза о YAKE «0.705 ... both embedders» противоречит таблице (0,705/0,422) — использовать таблицу. R@5 metadata-only 0,618 против random 0,132; R-precision остаётся <0,30.
Ограничение. Всего 38 датасетов из пяти workflows; поисковые запросы строятся из тех же экспертных ground-truth keywords, поэтому это не оценка реального пользовательского поиска. Нет throughput, p95, очередей или операционной стоимости. R-precision ниже 0,30: результат годится как список кандидатов, не готовый единственный ответ. Семантический F1 зависит от embedder и высокого chance floor. Текст ошибочно приписывает YAKE 0,705 обоим embedders; таблица III даёт 0,705/0,422 — использовать таблицу.
Для моей работы. Backend-инженеру полезен жизненный цикл регистрации, асинхронного enrichment и индексирования, а также явное сравнение полной документации родителей с короткими тегами. Вывод редактора — версионировать provenance-контекст и отдельно проверять качество поиска, а не только similarity с экспертной разметкой.
Следующий шаг. Повторить на своём каталоге сравнение локального README и README с parent keywords; оценивать retrieval на независимых запросах пользователей, добавить измерение очереди, стоимости и задержки индексирования.
Цена JavaScript-стека для coding-агента: измерить вместо угадать
backend
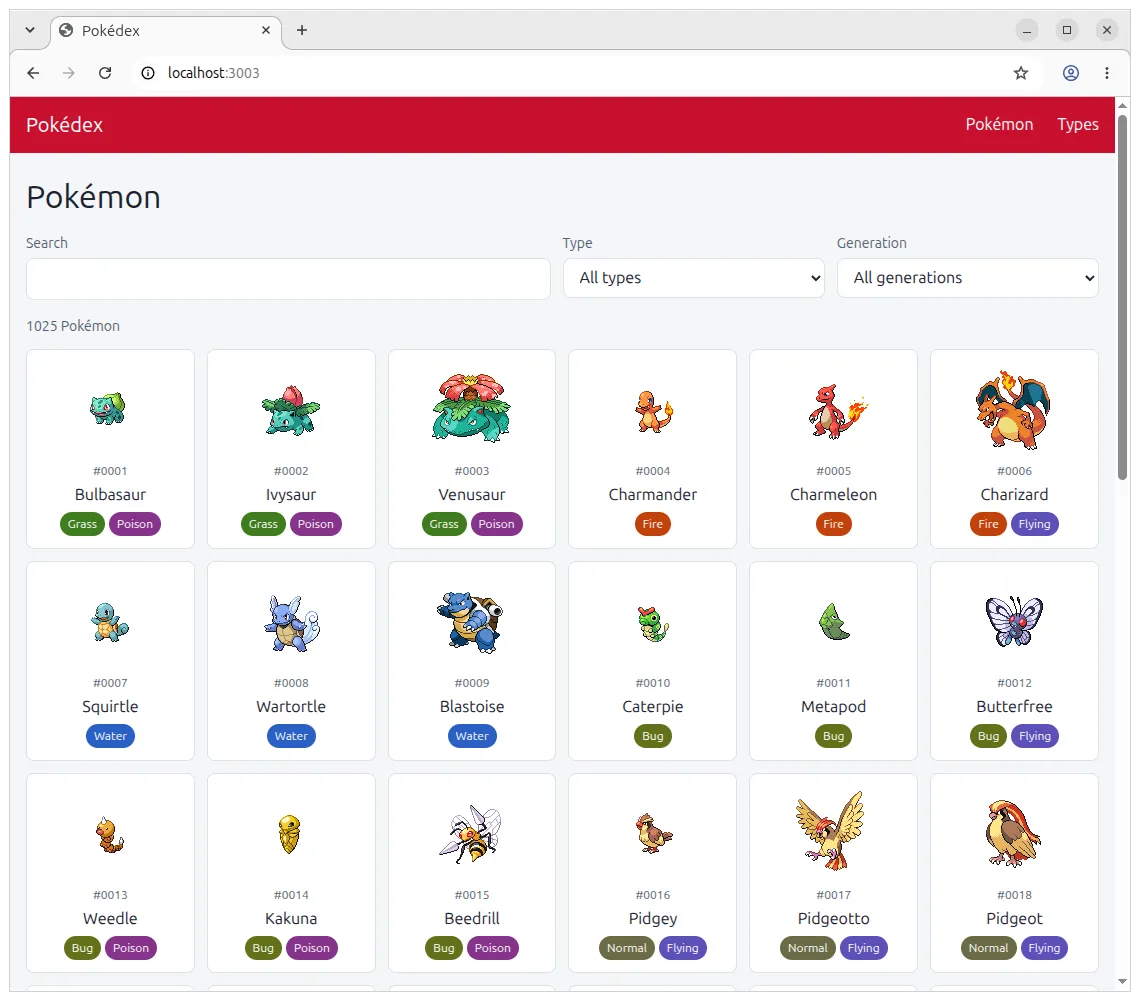
Nolan Lawson поручил Opus 5.5 собрать одно приложение на двенадцати JavaScript-стеках и сравнил стоимость, время, размер кода и Lighthouse. Важен не победитель, а воспроизводимый способ проверки: одинаковая спецификация, conformance-suite и несколько запусков. Случайные траектории агента и выбор архитектуры заметно меняют результат; переносить рейтинг на другой продукт рано.
Одно и то же Pokémon-приложение служит общей задачей для двенадцати стеков. ИсточникМетод, ограничения и следующий шаг
Как устроено. Для каждого стека автор выполнял пять сборок Pokémon-приложения в sandbox, предоставив официальные MCP или skills, если они существуют. Агент не знал о последующей проверке Lighthouse; conformance-тесты работали по accessibility-tree. Метрики стоимости включают пять попыток, а качество и размер Angular — три успешных приложения. Lighthouse выполнялся на mobile-профиле с CPU/network throttling.
Основание. Описание и примеры автора; код здесь не запускался. Hono+htmx: медиана $2,67 против Angular $4,97; диапазоны соприкасаются в $3,19. Angular: две из пяти сборок не дали измеримого приложения; стоимость включает их, performance — нет.
Ограничение. Одна модель Opus 5.5 high, один небольшой контентный Pokémon-продукт и только Chromium/mobile Lighthouse на заданном ноутбуке. MPA имеют преимущество в выбранных метриках. MCP/skills предоставляли, но их фактическое использование разнилось; архитектуру SSR/CSR не фиксировали. Два неуспешных Angular-прогона включены в стоимость, но исключены из performance и размера кода, поэтому эти выборки различаются. Стоимость — API-оценка Claude Code при подписке автора, не фактическая оплата за запуск; LOC не доказывает поддерживаемость.
Для моей работы. Для backend-инженера это шаблон сравнения стека собственного agent-generated интерфейса: считать стоимость всего запуска и проверять конечный продукт. Это моя интерпретация, а не универсальная рекомендация Hono или Astro.
Следующий шаг. Взять свою типовую задачу и сравнить два стека на нескольких повторах, фиксируя версию модели, тесты и стоимость неуспешных попыток.
Поиск багов ускорился сильнее, чем их проверка и исправление
backend
Robert Haas связывает задержку PostgreSQL 19 с потоком обнаруженных LLM дефектов: нагрузка выросла и на текущую ветку, и на старые релизы. Это свидетельство участника проекта о новом узком месте — review и backport, а не контролируемый эксперимент влияния AI. Полезно командам, которые ускоряют генерацию bug reports и патчей без расширения способности их проверять.
Метод, ограничения и следующий шаг
Как устроено. Автор сравнил число коммитов между feature freeze 8 апреля и 25 сентября в 2025 и 2026 годах. Отдельно рассмотрел master, стабильную ветку нового релиза и предыдущего. Он связывает поздние откаты крупных функций и задержку релиза с исправлением дефектов и отвлечением review на back-branches; причинное объяснение основано на опыте участия.
Основание. Описание и примеры автора; код здесь не запускался. Для текущей stable-ветки 724→1169 коммитов за сопоставимый период, более 60 %. Для предыдущего релиза 248→433, более 74 %. Это сравнение разных веток соседних лет, не causal estimate.
Ограничение. Сравнение числа коммитов соседних лет не устанавливает причинный эффект LLM и не измеряет время поиска, review или исправления. Нет разметки происхождения каждого report и контрольной группы. Рост 724→1169 (+61,5 %) и 248→433 (+74,6 %) относится к разным stable-веткам соседних релизных циклов. Прогноз релиза — мнение автора на дату статьи. Статья помечена как перепечатка авторского материала Neon; дата оригинальной публикации в сохранённой странице не указана.
Для моей работы. В своей команде измерять весь цикл: валидность report, время воспроизведения, очередь review и объём backport. Это мой вывод: увеличение числа находок само по себе не означает ускорение доставки.
Следующий шаг. Для agent-generated reports требовать минимальное воспроизведение и подтверждённое проявление; отдельно наблюдать время человеческого review.
Bobo Li, Jiajia Song, Hao Fei, Wynne Hsu, Mong Li Lee · · Препринт
Flide: общий контекст для множества решений без подмены входа
agents
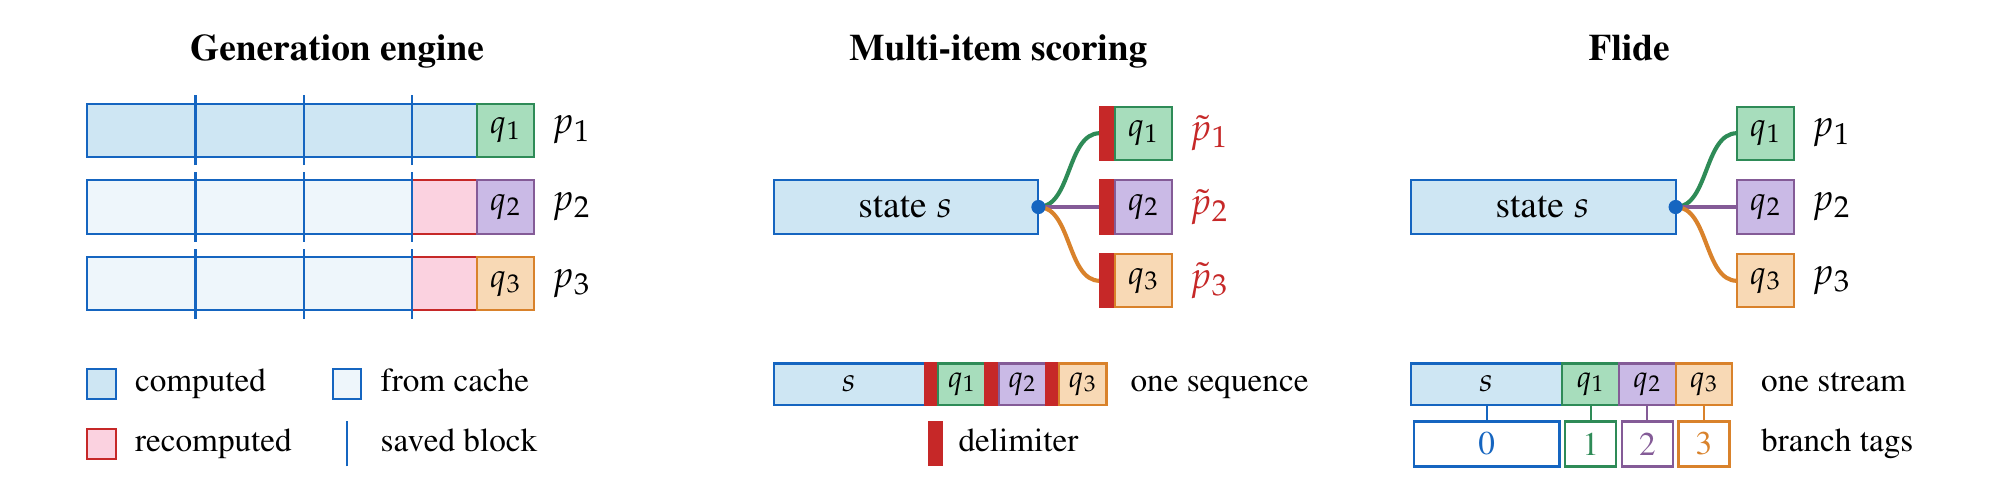
Flide обслуживает несколько коротких категориальных вопросов к одному длинному состоянию за общий проход. В отличие от склейки с delimiter, ветви сохраняют вычисление отдельного запроса, включая recurrent-слои гибридных моделей. Работа полезна для routing и проверок агента: ускорение достигается совместным исполнением, а точность вероятностей проверяется отдельно от правильности самого решения модели.
Flide переиспользует общий causal-state для множества вопросов об одном состоянии. ИсточникМетод, ограничения и следующий шаг
Как устроено. ForkAttention хранит логические зависимости запросов в GPU metadata, а физически исполняет плоский поток токенов. Attention видит общий trunk и собственную ветвь; Gated DeltaNet начинает каждую ветвь с точного состояния trunk. CUDA graphs переиспользуются по длине потока. Checkpoint позволяет продолжать растущую историю, а дополнительный batch-invariant режим фиксирует порядок floating-point reductions на той же аппаратной и программной конфигурации.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. Таблица 3: шесть публичных workloads, Qwen3.5 и Gemma 4, один H200, 1/8/32/64 closed-loop clients. До 9,5× ниже latency относительно лучшего vLLM/SGLang baseline наблюдается при множестве вопросов на одно состояние, а не на любом запросе. Appendix E: invariant-режим теряет не более 10% throughput на 64 clients в проверенных конфигурациях.
Ограничение. Специализированное категориальное inference, поддерживаемые архитектуры и один H200; это не универсальное ускорение text-generation. До 9,5× относится к конкретным multi-question workloads против лучшего из зафиксированных vLLM/SGLang, а под нагрузкой single-question задачи могут лишь совпадать с baseline. У SGLang иной template и MIS отключает CUDA graphs/cache. Exact arithmetic не равно bitwise: отдельный invariant-режим фиксирует reductions в той же аппаратной/программной среде и имеет цену по throughput.
Для моей работы. Мой вывод: при многократных guardrail-проверках одной истории можно совместно исполнять запросы, сохраняя их изоляцию. Нельзя считать delimiter-склейку семантически бесплатной: небольшое изменение вероятностей способно пересечь порог управляющего решения.
Следующий шаг. Для собственного decision endpoint сравнить isolated и batched вероятности, threshold flips и latency; затем проверить поддержку своей модели и повторить workload с реальным числом вопросов на одно состояние.
Mehil B Shah, Mohammad Masudur Rahman, Foutse Khomh · · Препринт
AIFaultBench связывает AI-сбои с окружением и уликами воспроизведения
agents
AIFaultBench объединяет 770 реальных дефектов из 105 AI-репозиториев: от ML и LLM до агентов и инфраструктуры. У каждой записи есть исходный report, версия кода, подготовка окружения, trigger и журнал расследования. Авторы воспроизвели 652 дефекта в зафиксированных условиях; оставшиеся не спрятали. Набор полезен для проверки инструментов диагностики и разбора того, почему воспроизведение не удалось.
Конвейер AIFaultBench отделяет подготовку дефекта, сбор свидетельств и воспроизводимость. ИсточникМетод, ограничения и следующий шаг
Как устроено. Из активных Python-репозиториев GitHub авторы сформировали пул закрытых issues, выбрали 1 000 кандидатов и оставили 770 содержательных сообщений о сбоях. На каждый дали до трёх часов ручного воспроизведения и повторяли запуск трижды с фиксированными условиями. Успех требовал совпадения ошибки при crash либо отклонения численного проявления не больше 5 %. Индексы и каталоги связывает единый bug_id.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. 770 дефектов, 105 репозиториев, 76 организаций; 652/770 = 84,7 %. Из 118 не воспроизведённых 46 упёрлись в недоступные ресурсы, 72 — в отсутствие симптома, version drift или nondeterminism. Все успешные симптомы проверяли тремя повторениями; лимит расследования — три часа на дефект.
Ограничение. Результат воспроизведения заявлен авторами и не перепроверен здесь; 652/770 относится к их фиксированным условиям и трём повторам. Набор смещён к популярным активным Python-репозиториям и полным public reports, не оценивает распространённость сбоев. Исторические зависимости могут стать недоступны, а воспроизведение симптома не доказывает правильность repair. В рекомендации использовать опубликованный фильтр reproducible=true (текст статьи), не неподтверждённый reproduced=true.
Для моей работы. Можно собрать реалистичный набор для debugging-агента, выбрав записи с reproducible=true и подходящим классом системы. Для backend это также пример формата инцидента: версия, окружение, команда, наблюдаемый исход и причина блокировки. Это моя рекомендация по использованию набора.
Следующий шаг. Выбрать несколько инфраструктурных или agentic дефектов, изучить setup и reproduction_trajectory, затем воспроизвести в одноразовой среде и добавить отдельные проверки поведения после исправления.
Elizabeth Gilbert, Chris Fallin, Heather Miller, Ben L. Titzer · · Препринт
Splicer: наблюдаемость и политики на типизированных границах Wasm-компонентов
agents
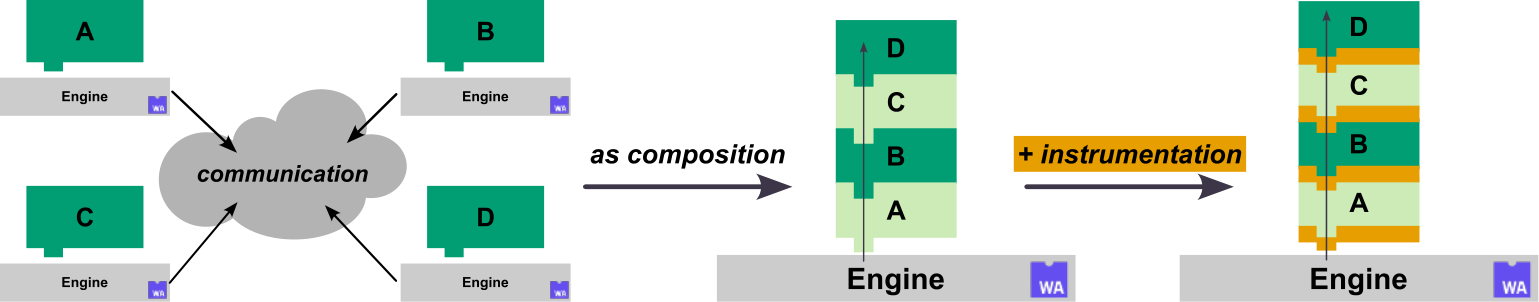
Splicer вставляет инструменты между WebAssembly-компонентами, сохраняя типы WIT и отдельные возможности доступа к данным. Такой слой позволяет описывать tracing, запись и воспроизведение или редактирование строк без переписывания каждого приложения. Для backend-инженера это конкретный вариант архитектуры изолированных инструментов: нужно явно выбрать границу наблюдения и минимальный доступ, а затем измерить стоимость копирования данных.
Splicer связывает компоненты и добавляет наблюдение за вызовами; это инфраструктура, а не эксперимент coding-агента. ИсточникМетод, ограничения и следующий шаг
Как устроено. Framework восстанавливает граф композиции из component binary, применяет YAML-правила к рёбрам и генерирует адаптеры. Четыре уровня дают имена вызовов, чтение payload, изменение данных или полную замену downstream. Авторы реализовали инструменты на Rust, Go и JavaScript, затем измерили bind time, размер кода и runtime overhead на WIT-микротестах и Wasm-порте Go DeathStarBench Hotel Reservation.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось. Стенд: два Xeon Platinum 8168, 96 ядер, 384 GiB RAM. DeathStarBench: 75% чтения, 20% записи, 5% авторизации; saturation определяется как <90% целевого RPS. Native Go насыщается при 8 000 RPS, Wasm/TCP при 2 500, ABI-композиция не насыщается при 12 000. Это сравнение разных коммуникационных архитектур; single-process композиция требует больше памяти.
Ограничение. Работа проверяет Wasm-инструментацию, а не поведение AI-агентов. Tiers 3–4 пока Rust-only, не поддерживают дополнительные host imports; resource-method reflection неполна, вызовы части возвращённых handles невидимы. Context propagation в tiers 1–2 требует внешнего процесса. DeathStarBench изменён и работает на localhost; переход TCP→in-process ABI меняет архитектуру, поэтому 12 000 RPS нельзя считать выигрышем одной инструментации или переносить на сетевой production. Независимый запуск не выполнен.
Для моей работы. Мой вывод: подход подходит для исследования изолированного исполнения агентных инструментов и типизированных политик на границе вызова. Он потребует компонентной Wasm-архитектуры и не становится заменой сетевой наблюдаемости обычного сервиса сам по себе.
Следующий шаг. Проверить на одном небольшом Go/Wasm-компоненте name-only tracing и read-only recorder; измерить p50/p99 и стоимость payload-копирования относительно варианта без interposition.
Маршрутизация поддержки через Decisions API с проверкой ответа и передачей человеку
backend
Cookbook показывает завершённую схему классификации: четыре очереди поддержки, типизированный choice-запрос, разбор результата и резервная очередь human_review. Особенно полезна граница между успешным HTTP-ответом и пригодным решением: отказ модели или неверная структура не должны автоматически превращаться в назначение тикета. Пример демонстрирует workflow на десяти банковских сообщениях и прямо не заявляет производственную точность.
Метод, ограничения и следующий шаг
Как устроено. Notebook для Python 3.10+ формирует POST /v1/decisions с gpt-6-luna, инструкцией и описаниями очередей. Сообщение клиента передаётся как свидетельство, а правила маршрутизации остаются отдельно. После десяти отдельных запросов parser проверяет тип, имя вопроса, допустимую очередь и диапазон confidence; отказ или непригодный ответ возвращает None, который приложение отображает в human_review.
Основание. Описание и примеры автора; код здесь не запускался. Каждый полный запуск делает десять оплачиваемых запросов, а не один batch API вызов. Timeout 30 секунд, redirects запрещены, автоматических retries нет; замер включает установку соединения и сеть. Пример confidence 0,92 и probabilities в ответе иллюстративен, это не зарегистрированный результат.
Ограничение. Только gpt-6-luna и четыре заранее заданные очереди; для неизвестных интентов требуется other или scope-check. Десять BANKING77-примеров демонстрируют workflow, а не production accuracy. Заявление о скорости около 10× пересказано из API guide и этим notebook не проверялось. Код/API здесь не запускались; confidence не означает calibrated correctness.
Для моей работы. Мой вывод: для backend-маршрутизатора важнее контракт валидации и отдельный исход отказа, чем доверие confidence как готовому SLA. Request builder и parser должны использовать один набор допустимых значений.
Следующий шаг. Перенести схему на свои очереди, добавить other или проверку области и выбрать порог ручного разбора на размеченной выборке. Перед подключением ticket assignment отдельно проверить отказ и непригодный ответ.